De mi primera GeForce a la fábrica de la IA: la historia de NVIDIA
Hay empresas que admiras por lo que valen en bolsa. Y hay empresas que admiras porque formaron parte de tu vida antes de que supieras qué era la bolsa. NVIDIA, para mí, es de las segundas.
De más joven ahorré durante meses para comprarme mi primera GeForce. Quería jugar en condiciones a los juegos de la época, los de mi generación, como Age of Empires… y recuerdo perfectamente la sensación de abrir la caja.
Quien vivió aquella época sabe de lo que hablo. Las revistas de informática comparando qué tarjeta movía mejor el Quake III, las tardes instalando los drivers Detonator, los primeros juegos en los que el agua parecía agua y la luz se movía de verdad… Cada nueva GeForce era un pequeño salto, y cada juego nuevo, una excusa para ahorrar otra vez.
No sabía que esa tarjeta, pensada para que los juegos se vieran mejor, iba a acabar siendo la base de la revolución tecnológica más grande que he vivido.
Así que me ha parecido un buen momento para contar cómo una empresa que nació en una cafetería de carretera ha llegado hasta aquí.
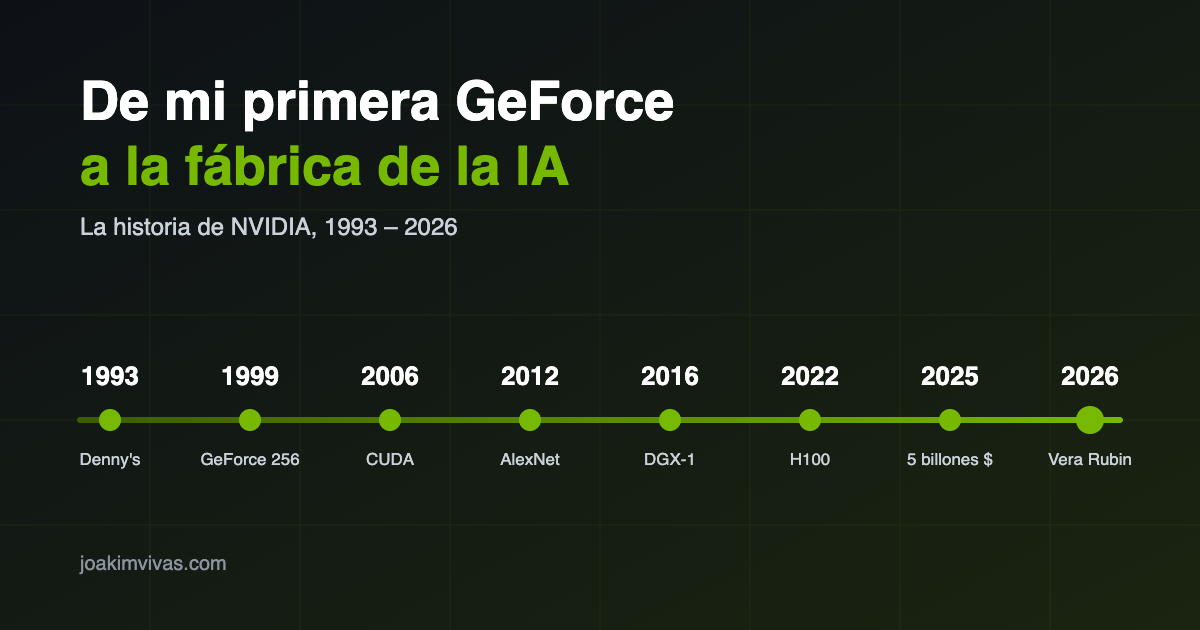 33 años en ocho momentos: del Denny’s de 1993 a Vera Rubin en 2026.
1993: tres ingenieros en un Denny’s
El 5 de abril de 1993, Jensen Huang, Chris Malachowsky y Curtis Priem fundaron NVIDIA. La idea la habían ido dando forma entre cafés en un Denny’s de East San José, una cadena de restaurantes de carretera (en 2023, cuando NVIDIA superó el billón de dólares, pusieron una placa en aquella mesa). La apuesta era clara: los gráficos 3D iban a cambiar los videojuegos y, para eso, hacía falta un chip especializado.
Los inicios fueron cualquier cosa menos fáciles:
- Su primer producto, el NV1 (1995), dibujaba con superficies curvas en lugar de triángulos. Cuando Microsoft estandarizó Direct3D… con triángulos, NVIDIA se quedó en fuera de juego.
- Estaban desarrollando un chip para la siguiente consola de Sega y Jensen tuvo que decirle a Sega que no iba a funcionar. Aun así, el presidente de Sega, Shoichiro Irimajiri, decidió invertir 5 millones de dólares en NVIDIA. Ese dinero les dio unos seis meses de vida.
- Con esos seis meses construyeron el RIVA 128 (1997). Llegó cuando les quedaba dinero para pagar, más o menos, un mes de nóminas. Vendieron alrededor de un millón de unidades en cuatro meses. Se salvaron.
De ahí viene una frase que Jensen Huang ha repetido durante más de tres décadas: “Nuestra empresa está a 30 días de la quiebra”. A finales de 2025 todavía reconocía que la sigue usando. Con una empresa de billones de dólares.
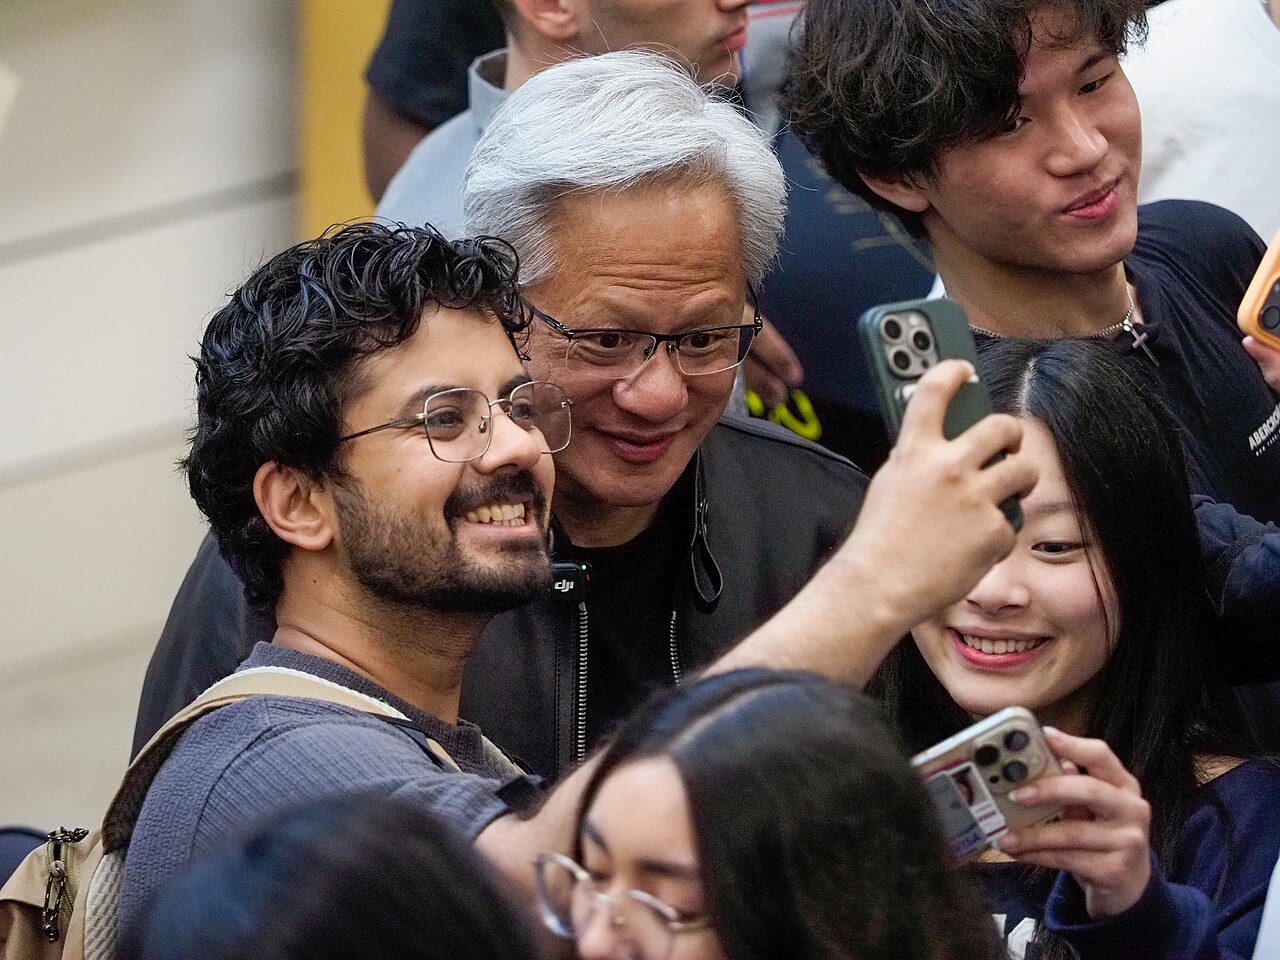 Jensen Huang con estudiantes en Stanford, en abril de 2026. Siempre con su chaqueta de cuero. Foto: Anderseidesvik, CC BY-SA 4.0, vía Wikimedia Commons.

1999: la GeForce 256 y “la primera GPU del mundo”
En enero de 1999, NVIDIA salió a bolsa en el Nasdaq a 12 dólares por acción. Y el 31 de agosto de 1999 presentó la GeForce 256, que vendió como “la primera GPU del mundo”.
¿Qué tenía de especial? Hasta entonces, el procesador del ordenador (la CPU) se encargaba de calcular la geometría de cada escena: dónde está cada objeto, cómo le da la luz… y la tarjeta gráfica solo “pintaba”. La GeForce 256 hacía también esos cálculos (lo que se llamó transform & lighting por hardware), liberando a la CPU. Era un procesador dedicado a los gráficos, de ahí el nombre: GPU, Graphics Processing Unit.
¿Fue realmente la primera? Depende de a quién preguntes: Jon Peddie Research la considera la primera GPU totalmente integrada. Pero el nombre se quedó. Y con él, una generación entera, la mía, que empezó a ahorrar para tener una GeForce. Después vinieron la GeForce 2, la GeForce 3 (de la que salió el chip de la primera Xbox) y todas las demás.
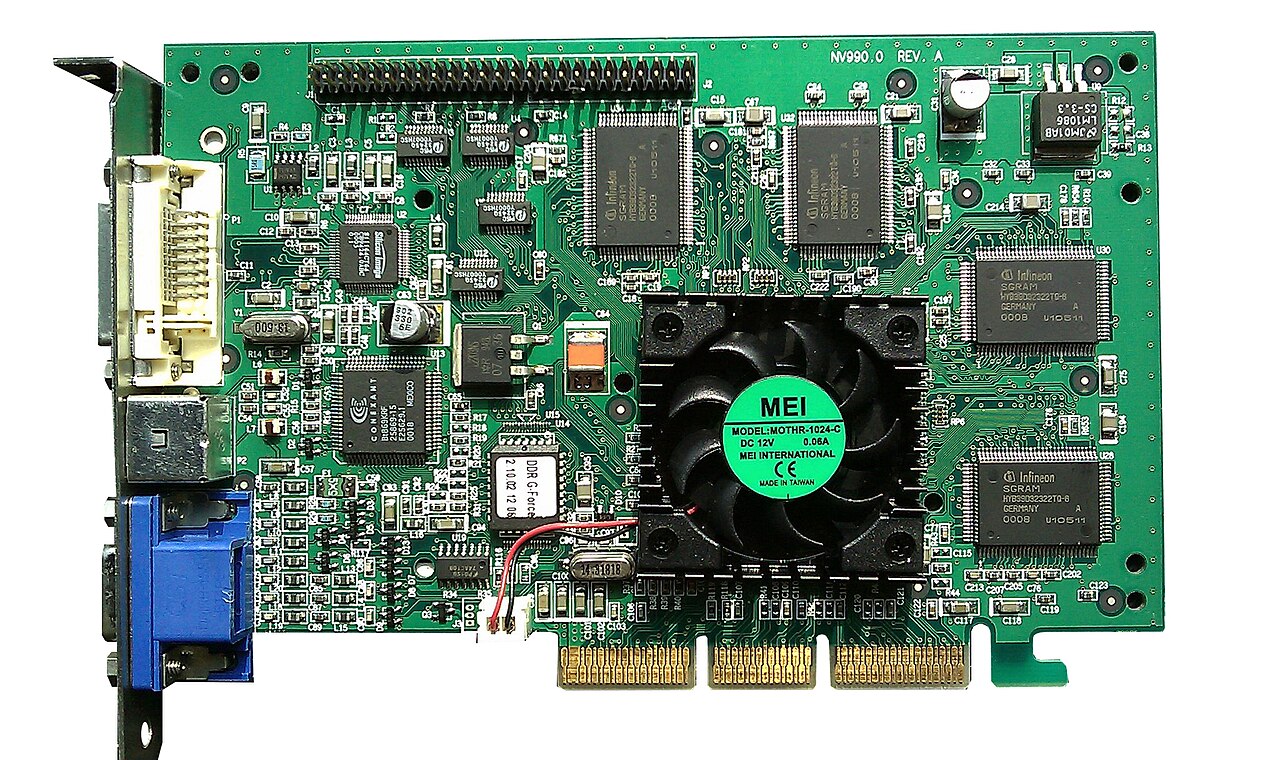 Una GeForce 256 de 1999 (versión de VisionTek). Bajo ese ventilador, “la primera GPU del mundo”. Foto: Hyins, dominio público, vía Wikimedia Commons.

Los juegos que marcaron un antes y un después
Si hay algo que explica el éxito de NVIDIA en aquellos años, son los juegos. Cada generación de tarjetas venía acompañada de un título que la exprimía… y que te obligaba a cambiar de tarjeta:
- Quake III Arena (1999): salió apenas unos meses después de la GeForce 256 y se convirtió en el banco de pruebas de la época. Solo funcionaba con aceleración 3D, y los fotogramas por segundo en Quake III eran la forma de comparar cualquier tarjeta.
- Halo (2001): la primera Xbox llevaba un chip gráfico de NVIDIA, derivado de la GeForce 3. Halo fue la demostración de que una consola podía tener gráficos de PC, y la puerta de entrada de NVIDIA en las consolas.
- The Elder Scrolls III: Morrowind (2002): su agua con pixel shaders fue de esas cosas que se te quedan grabadas. Para verla en todo su esplendor necesitabas una tarjeta con DirectX 8, como la GeForce 3. Fue la primera vez que muchos vimos agua que parecía agua.
- Doom 3 (2004): iluminación y sombras dinámicas en tiempo real, con John Carmack llevando el hardware al límite. La nueva GeForce 6800 fue de las tarjetas que mejor lo movían.
- Far Cry (2004): aquellas islas tropicales, con su vegetación y su agua, fueron uno de los primeros juegos en aprovechar el Shader Model 3.0 de la GeForce 6, gracias a un parche desarrollado con NVIDIA.
- Crysis (2007): tan exigente que dio lugar a una pregunta que todavía hoy es un meme: "¿Pero puede mover el Crysis?". La GeForce 8800 GTX era casi la única que podía hacerlo con cierta dignidad… y era, además, la primera tarjeta con CUDA. Pero esa es otra historia.
Detrás de muchos de estos juegos estaba el programa “The Way It’s Meant to Be Played”, con el que NVIDIA trabajaba codo con codo con los estudios para que sus juegos sacaran partido de cada nueva tarjeta. Fue la primera vez que NVIDIA entendió algo que luego aplicaría a la IA: no basta con tener el mejor chip; tienes que tener a los desarrolladores de tu lado.
2006: CUDA, la apuesta que nadie entendía
Aquí está, para mí, la decisión más importante de la historia de NVIDIA.
Una GPU es, en el fondo, un chip con miles de pequeños procesadores que hacen muchas operaciones sencillas en paralelo. Perfecto para gráficos… pero también para cualquier cálculo que se pueda dividir en millones de trocitos: simulaciones físicas, finanzas, ciencia y, sobre todo, redes neuronales.
En noviembre de 2006, NVIDIA presentó CUDA: una forma de programar sus GPUs para cualquier cosa, no solo para gráficos. Y lo hizo en todas sus tarjetas, incluidas las de juegos. Durante años, Wall Street no entendió por qué una empresa de tarjetas gráficas gastaba tanto dinero en algo que casi nadie usaba.
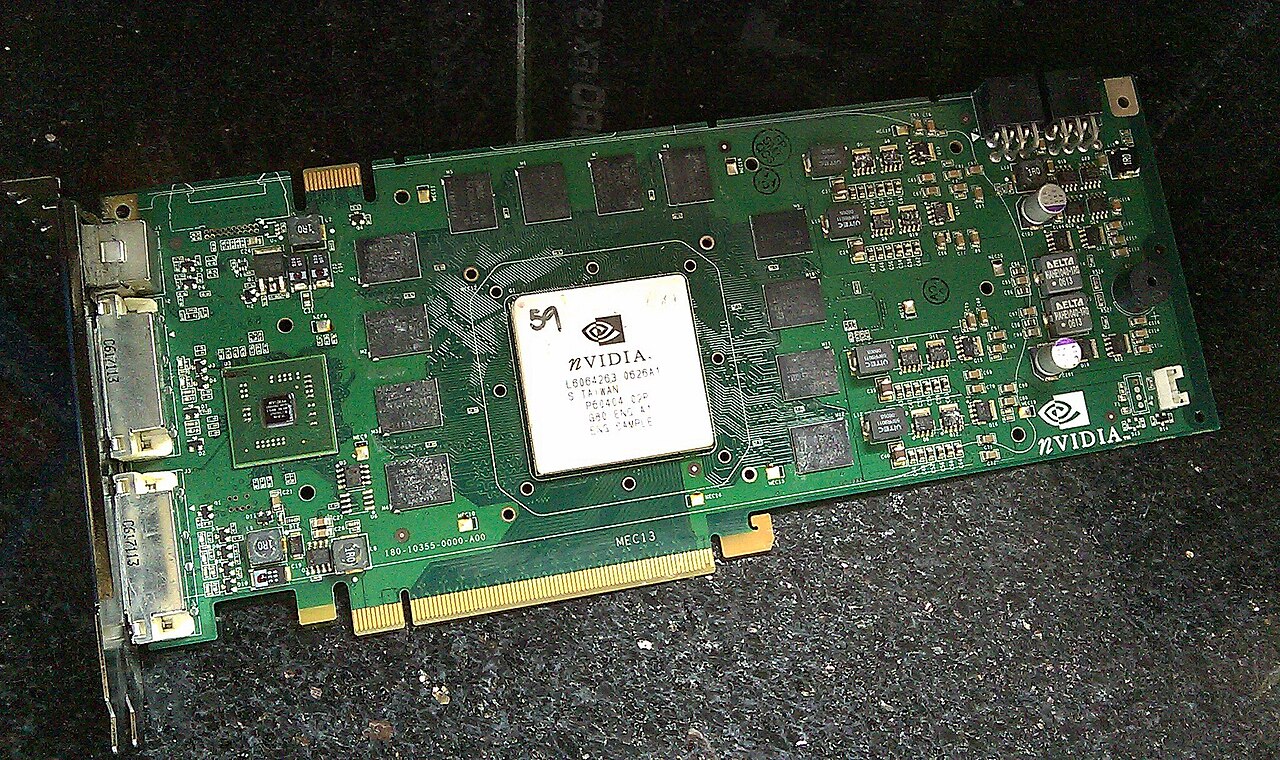 Una GeForce 8800 GTX sin disipador: en el centro, el chip G80, la primera GPU de NVIDIA con CUDA. Foto: Hyins, dominio público, vía Wikimedia Commons.

2012: AlexNet y el momento en que todo cambió
En 2012, tres investigadores de la Universidad de Toronto, Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton, presentaron AlexNet al concurso de reconocimiento de imágenes ImageNet. Ganaron por goleada. ¿Y con qué la entrenaron? Con dos tarjetas gráficas GeForce GTX 580, de las que se usaban para jugar.
Ese fue el momento en que el mundo descubrió que las GPUs y CUDA eran la herramienta perfecta para el deep learning. La apuesta de 2006 empezaba a dar sus frutos.
2016: Jensen entrega en mano el primer DGX-1… a OpenAI
En agosto de 2016, Jensen Huang se presentó en persona en las oficinas de una pequeña organización de investigación de San Francisco para entregarles el primer DGX-1, un “superordenador en una caja” diseñado para IA. La dedicatoria decía: “To Elon & the OpenAI team”. Sí, esa OpenAI.
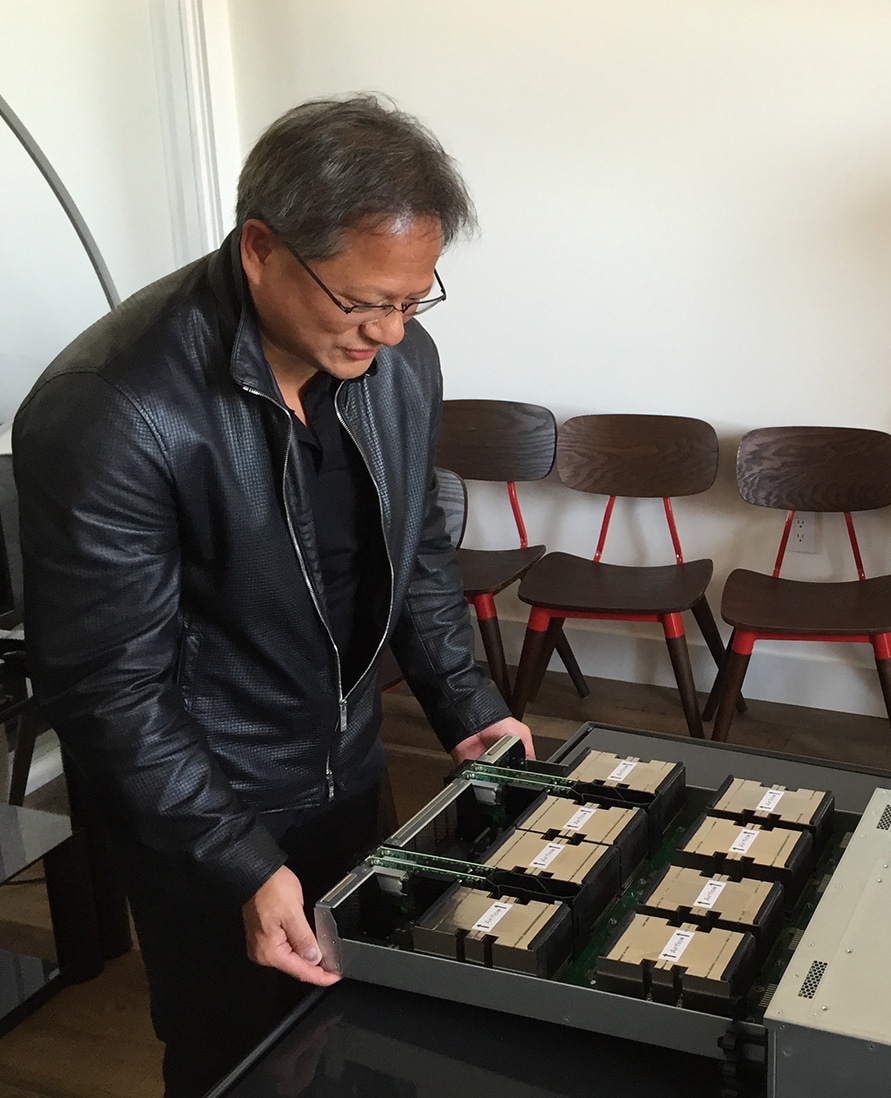 Agosto de 2016: Jensen Huang abre la bandeja con las ocho GPUs del primer DGX-1, recién entregado en las oficinas de OpenAI en San Francisco. Foto: NVIDIA.
Seis años después, en noviembre de 2022, saldría ChatGPT. Y el mundo entero descubriría para qué servían realmente todas esas GPUs.
Y como a Jensen le gustan los símbolos, casi diez años después repitió el gesto: en octubre de 2025 entregó en mano a Elon Musk, en la base de SpaceX en Texas, uno de los primeros DGX Spark, un superordenador de IA de un petaflop que cabe encima de una mesa.
2019-2026: de vender tarjetas a construir fábricas de IA
A partir de aquí, NVIDIA deja de ser “la de las tarjetas gráficas” y se convierte en la empresa que construye la infraestructura de la IA:
- 2020: compra Mellanox por unos 7.000 millones de dólares. Muchos no lo entendieron, pero entrenar un modelo grande es conectar miles de GPUs, y Mellanox era la red que las conecta. Ese mismo año anuncia la compra de Arm por 40.000 millones… que los reguladores acabaron tumbando en 2022.
- 2020-2022: llegan las A100 y las H100, las GPUs con las que se ha entrenado buena parte de la IA generativa que usamos hoy (incluidas las 4.480 H100 de la partición acelerada de MareNostrum 5).
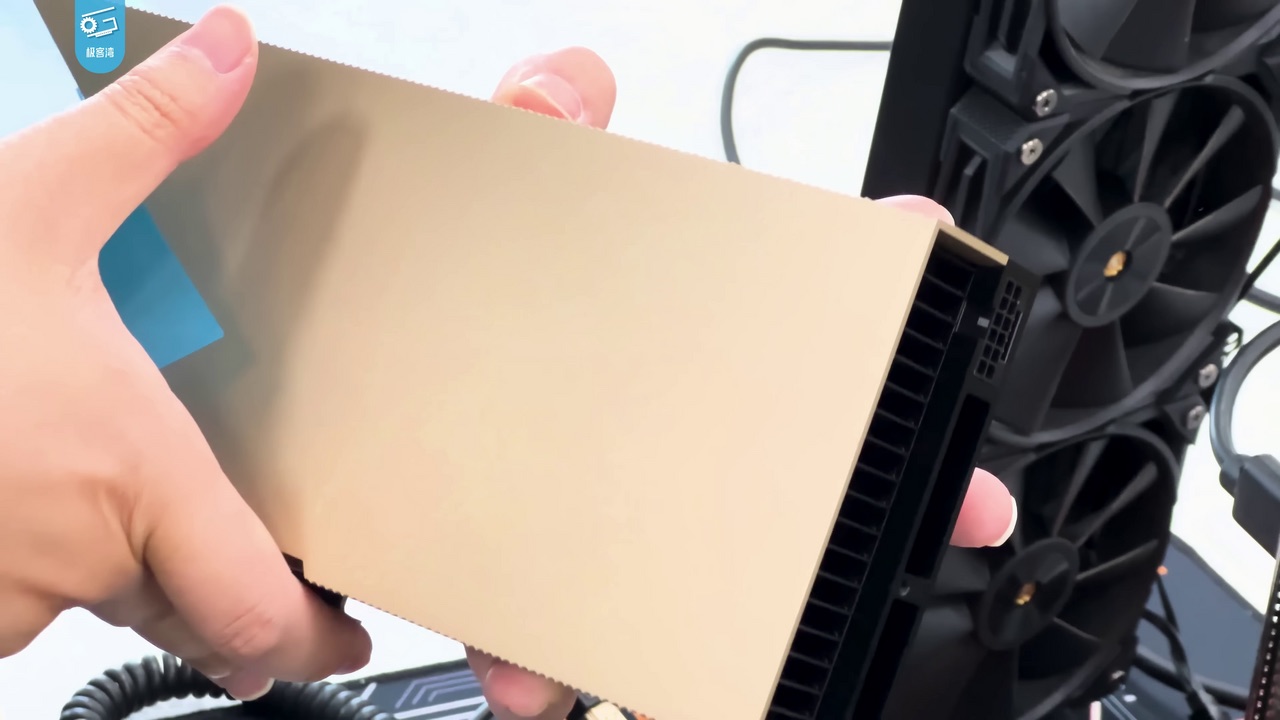 Una NVIDIA H100, la GPU con la que se ha entrenado buena parte de la IA generativa. Foto: 极客湾Geekerwan, CC BY 3.0, vía Wikimedia Commons.

- 2024-2026: Blackwell y, desde este verano, Vera Rubin, que según NVIDIA ya está en plena producción. Y una hoja de ruta con un ritmo de una arquitectura nueva cada año.
Y los números son de vértigo. En julio de 2025, NVIDIA se convirtió en la primera empresa de la historia en valer 4 billones de dólares, y en octubre de 2025, en la primera en superar los 5 billones. En su último trimestre (agosto de 2026) facturó 96.200 millones de dólares, el doble que un año antes, y el 92% vino de los centros de datos. Jensen lo resumió con una frase: “Ahora, la computación es ingresos”.
La empresa que fabricaba mi tarjeta para jugar hoy obtiene más de nueve de cada diez dólares de vender infraestructura para IA.
Las grandes fábricas de IA
Para entender la escala de lo que está pasando, nada mejor que ver algunos de los centros de datos que funcionan hoy con GPUs de NVIDIA. Ya no hablamos de “superordenadores”, sino de auténticas fábricas de IA que se miden en gigavatios:
- Colossus (xAI, Memphis): la de Elon Musk. En 2024, xAI y NVIDIA montaron un clúster de 100.000 GPUs Hopper en solo 122 días, algo que normalmente lleva años, y luego lo duplicaron. Su ampliación, Colossus 2, apunta según varias estimaciones a más de medio millón de GPUs Blackwell.
- Stargate (OpenAI y Oracle, Abilene, Texas): el buque insignia del proyecto Stargate. Desde junio de 2025 funciona con racks NVIDIA GB200, y ahí se ha entrenado GPT-5.5. Y es solo el principio: Stargate suma ya más de 5 GW en desarrollo y más de 2 millones de chips.
- Fairwater (Microsoft, Wisconsin y Atlanta): Microsoft ha conectado dos centros de datos para crear lo que llama una “superfábrica de IA”: una sola red capaz de unir cientos de miles de GPUs GB200 y GB300 como si fueran un único ordenador.
- JUPITER (Jülich, Alemania): el primer superordenador europeo de exaescala, inaugurado en septiembre de 2025, con unos 24.000 superchips Grace Hopper. Un trillón de operaciones por segundo… en Europa.
- Industrial AI Cloud (Deutsche Telekom, Múnich): la primera fábrica de IA para la industria de Alemania, en marcha desde febrero de 2026 con hasta 10.000 GPUs Blackwell. Una de las piezas clave de la IA soberana europea.
- MareNostrum 5 (BSC, Barcelona): y en casa, nuestro MareNostrum, con sus 4.480 H100 y la ampliación de la BSC AI Factory.
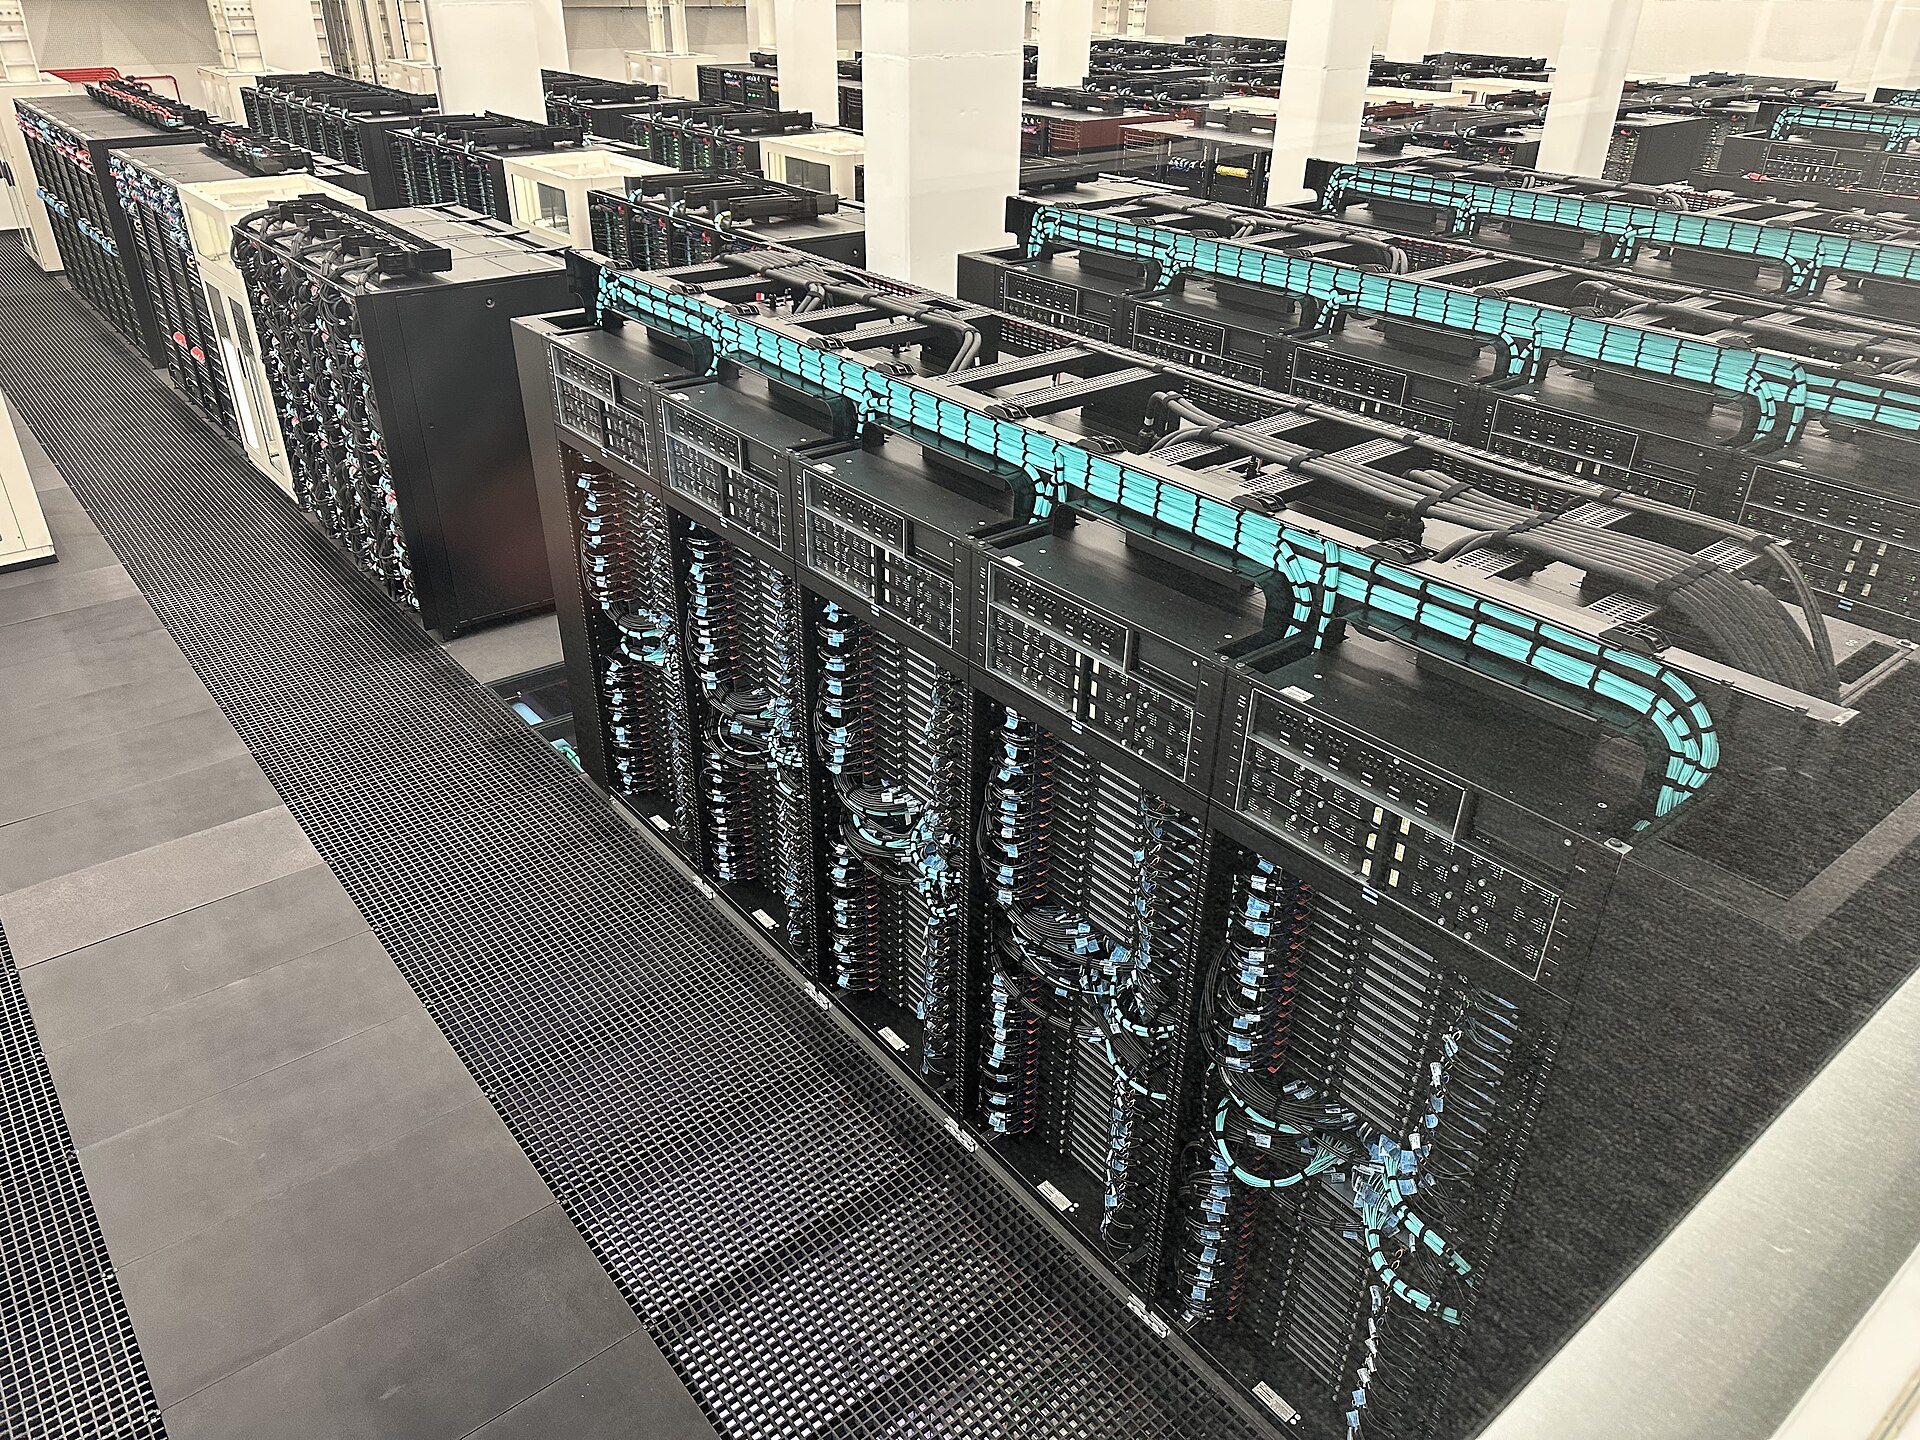 MareNostrum 5, en el Barcelona Supercomputing Center: hileras de racks que esconden miles de GPUs. Foto: Steve Jurvetson, CC BY 4.0, vía Wikimedia Commons.

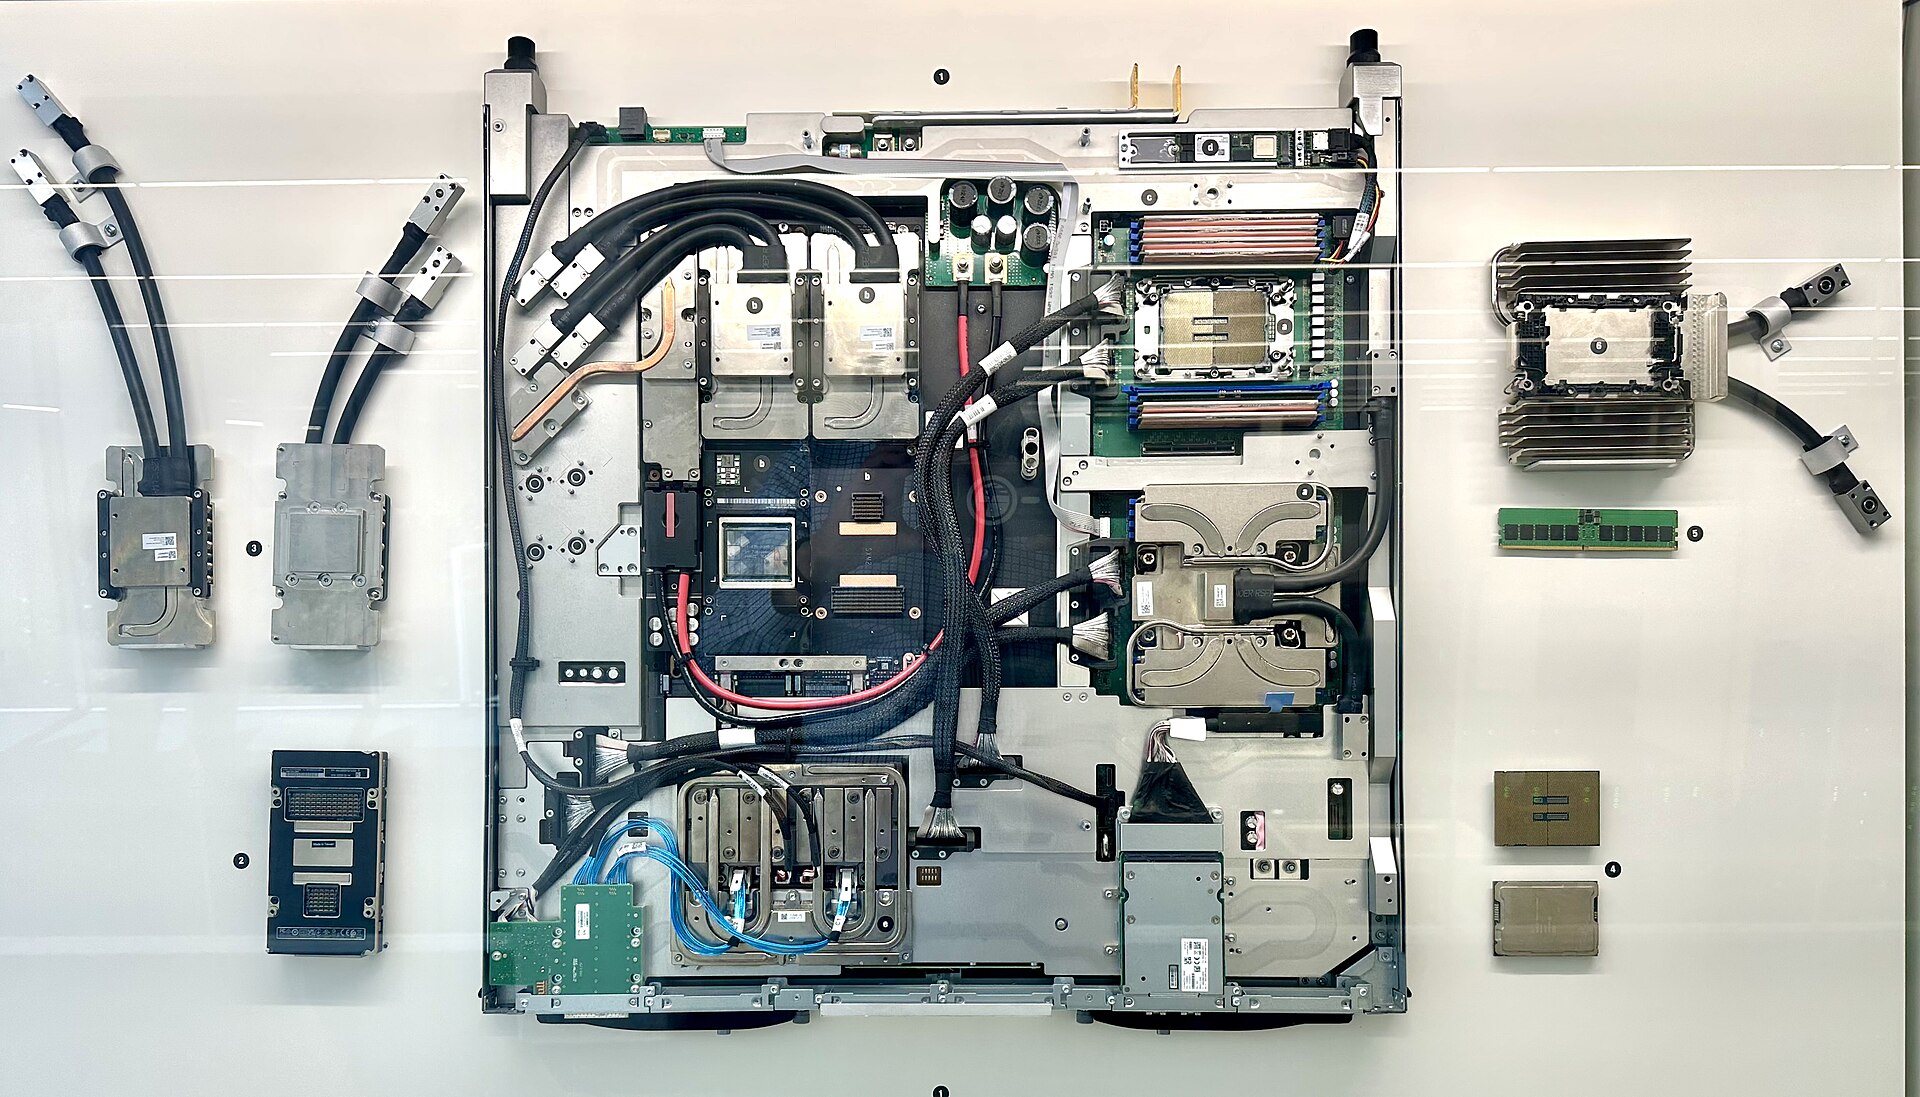 Y por dentro: una cuchilla de GPUs de MareNostrum 5 con refrigeración líquida. A esta escala, el aire ya no es suficiente para enfriar los chips. Foto: Steve Jurvetson, CC BY 4.0, vía Wikimedia Commons.

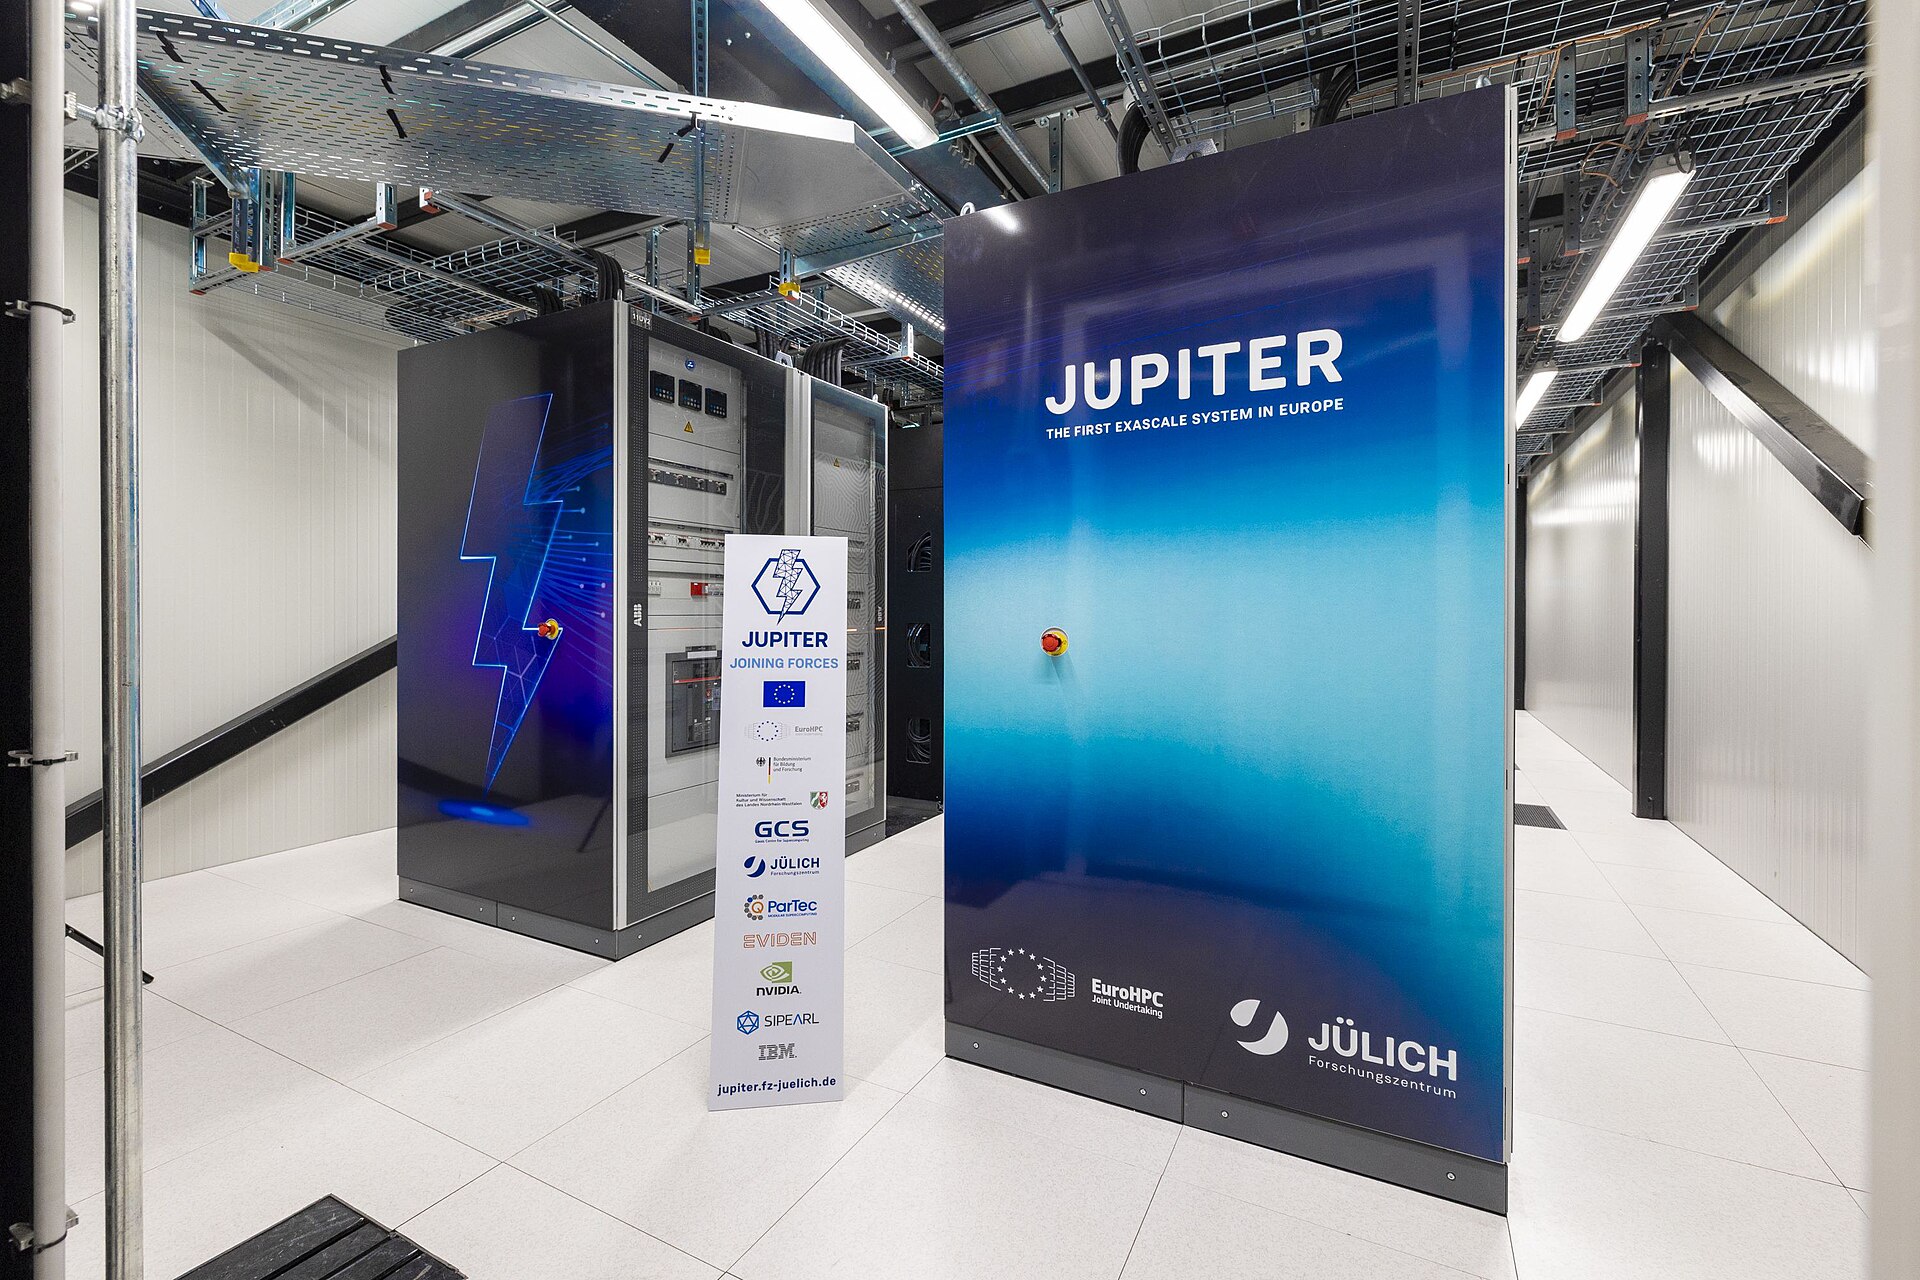 JUPITER, en Jülich (Alemania): “el primer sistema de exaescala de Europa”. Foto: Forschungszentrum Jülich / Sascha Kreklau, CC BY 4.0, vía Wikimedia Commons.

Para que te hagas una idea: un solo gigavatio es, más o menos, lo que consume una ciudad mediana. Y estas fábricas ya se cuentan por gigavatios.
CUDA: el verdadero imperio de NVIDIA
Si me preguntas por qué NVIDIA domina, la respuesta no es solo que haga los mejores chips. Es que lleva veinte años construyendo software alrededor de ellos. Y todo empieza, y acaba, en CUDA.
¿Qué es CUDA, explicado fácil?
Un procesador normal (la CPU) es como un puñado de cocineros muy buenos que preparan los platos de uno en uno, con mucho detalle. Una GPU es como una cocina con miles de ayudantes que solo saben hacer cosas sencillas… pero todos a la vez. Si tienes que pelar un millón de patatas, gana la GPU por goleada.
CUDA es el idioma que permite decirle a esos miles de ayudantes qué tienen que hacer. Los programadores escriben en C, C++ o Python un pequeño trozo de código (un kernel), y CUDA se encarga de repartirlo entre miles de núcleos que lo ejecutan en paralelo. Y entrenar una red neuronal, al final, no es más que eso: multiplicar matrices gigantes millones de veces. Pelar patatas, pero a lo bestia.
20 años después: el foso que nadie ha podido cruzar
En el GTC de marzo de 2026, Jensen celebró el 20 aniversario de CUDA recordando que hoy funciona en cientos de millones de GPUs y está en todas las nubes y en todos los fabricantes de ordenadores. Y en Berlín, NVIDIA habló de más de 11 millones de desarrolladores en su plataforma.
Ese es su verdadero foso defensivo. Durante veinte años, universidades, empresas y startups han escrito su código para CUDA. Cambiar de proveedor no es cambiar de chip: es reescribir y volver a optimizar todo. Es también por lo que Huawei intenta romper su monopolio con otra estrategia: si no puedes ganar chip a chip, conecta más chips.
Encima de CUDA, NVIDIA ha ido construyendo cientos de librerías especializadas, lo que llama CUDA-X. Algunas de las más importantes:
- cuDNN: la base sobre la que funcionan PyTorch o TensorFlow. Casi cualquier modelo de IA que conozcas ha pasado por aquí.
- RAPIDS (con cuDF y cuGraph): análisis de datos y de grafos en GPU. Lo que antes tardaba horas con Pandas, en minutos.
- cuOpt: optimización de rutas y logística.
- cuQuantum: simulación de ordenadores cuánticos en GPUs clásicas.
De las librerías a las plataformas: PhysicsNeMo, NeMo y compañía
Y aquí es donde NVIDIA da el salto: ya no ofrece solo herramientas, sino plataformas completas para cada industria. Las que más me interesan:
- PhysicsNeMo (antes llamado Modulus): un framework abierto para crear IA que respeta las leyes de la física. Combina redes neuronales informadas por la física (PINNs), operadores neuronales y redes de grafos. ¿Para qué sirve? Para que un modelo de IA simule un fluido, una estructura o el clima miles de veces más rápido que un simulador clásico… sin “inventarse” resultados físicamente imposibles. Es la base de los gemelos digitales de nueva generación.
- NeMo: la familia de NVIDIA para construir, personalizar y desplegar modelos de lenguaje, con piezas como NeMo Guardrails para poner límites a lo que puede hacer un modelo. Y sobre todo:
- NeMo Agent Toolkit (antes AgentIQ): una librería abierta para conectar, observar y evaluar equipos de agentes de IA. Lo interesante es que no te obliga a casarte con nadie: funciona con LangChain, LlamaIndex, CrewAI o Semantic Kernel, se integra con herramientas de observabilidad como Langfuse, incluye un sistema de evaluación y habla MCP, tanto como cliente como servidor. Si te interesan los agentes, encaja perfectamente con los 17 patrones de arquitecturas agénticas de los que ya te hablé.
- Nemotron y NIM: modelos abiertos de NVIDIA y microservicios listos para desplegarlos en cualquier sitio, de tu portátil a un centro de datos.
- Omniverse e Isaac: simulación, gemelos digitales y robótica. Lo verás en acción un poco más abajo con Disney.
- Earth-2 para el clima y Clara para la salud.
¿Ves el patrón? NVIDIA ya no vende chips. Vende todo lo necesario para que no tengas que pensar en el chip: de la GPU al modelo, y del modelo al agente que lo usa. Y cada capa hace un poco más difícil irse.
OpenClaw y el “harness”: la IA ya no es el modelo, es la integración
Si llevas tiempo construyendo sistemas con IA, sabrás algo que a mucha gente le cuesta ver: el modelo es solo una pieza. Lo difícil (y lo valioso) es todo lo que hay alrededor: conectarlo a tus datos, darle herramientas, controlar qué puede hacer y vigilar lo que hace. Eso es lo que en el mundo de los agentes se llama el harness, el “arnés”.
En el GTC de Berlín, Jensen lo explicó con una definición que me pareció perfecta: un agente es “un modelo, un arnés, un sandbox, conocimiento y herramientas”. El modelo piensa; el arnés es el bucle que decide qué hacer, llama a las herramientas, guarda la memoria y conecta al agente con el mundo; y el sandbox es la caja de la que no puede salir. Como un caballo muy potente: sin riendas, no lo quieres en tu casa.
OpenClaw: el agente que se comió el mundo
Y si hay un proyecto que ha puesto todo esto en el centro de la conversación en 2026, es OpenClaw.
Lo creó el programador austriaco Peter Steinberger en noviembre de 2025 como un proyecto personal. Después de pasar por varios nombres (entre ellos Clawdbot y Moltbot, que tuvo que cambiar tras una queja de marca de Anthropic), el 30 de enero de 2026 se quedó con el definitivo: OpenClaw, con una langosta como mascota.
¿Qué es? Un agente de IA de código abierto que funciona en tu propio ordenador, usa el modelo que tú elijas (Claude, GPT, DeepSeek o uno abierto) y con el que hablas por WhatsApp, Telegram, Signal o Discord, como si fuera un compañero más. Puede leer tu correo, gestionar tu calendario, programar o automatizar tareas, y aprende “habilidades” nuevas que no son más que carpetas con un fichero SKILL.md que le explica cómo hacer algo.
El éxito fue brutal: en marzo de 2026 ya superaba las 247.000 estrellas en GitHub, uno de los crecimientos más rápidos de la historia del código abierto. En febrero, Steinberger se incorporó a OpenAI y el proyecto pasó a una fundación independiente.
Pero, como ya te imaginas, un agente con acceso a tu correo, tus contraseñas y tus mensajes tiene un lado oscuro:
- Es vulnerable a la prompt injection: un correo o una web maliciosa pueden “darle órdenes”.
- El equipo de seguridad de Cisco encontró una habilidad de terceros que robaba datos sin que el usuario se enterara.
- China llegó a prohibir su uso en los ordenadores de organismos y empresas públicas.
Es la misma lección de siempre, la de los frigoríficos de los supermercados: conectar algo potente sin controlar sus permisos es abrirle la puerta a cualquiera.
NemoClaw y OpenShell: NVIDIA pone las riendas
Y aquí es donde entra NVIDIA. En el GTC de marzo de 2026, Jensen fue muy claro: “OpenClaw es el sistema operativo de la IA personal”. Y anunció NemoClaw, una distribución de OpenClaw que se instala con un solo comando e incluye dos cosas:
- Los modelos abiertos Nemotron, para que el agente pueda funcionar en local, en tu PC con una RTX o en un DGX Spark, sin mandar tus datos a ningún sitio.
- OpenShell, un entorno que mete a cada agente en su propio sandbox aislado, con políticas que definen exactamente a qué ficheros, a qué conexiones de red y a qué servicios puede acceder.
Empresas como Cadence, Dassault Systèmes, Siemens o Synopsys ya la están usando para construir agentes de ingeniería. Y en Berlín, NVIDIA fue un paso más allá con una arquitectura de referencia para agentes seguros, porque, como dijo Jensen, “cada vez que se lanza un agente, los privilegios son distintos”.
¿Por qué me parece tan importante? Porque confirma algo que defiendo desde hace tiempo, cuando hablo de los patrones de arquitecturas agénticas o de automatizar con n8n: el futuro de la IA no se juega en el modelo, se juega en la integración. En cómo conectas los agentes con tus sistemas, qué les dejas hacer, cómo los vigilas y cómo los paras si hace falta. NVIDIA, que empezó vendiendo el chip, ahora también quiere venderte el arnés.
De vuelta a los videojuegos: DLSS 5, el “momento GPT” de los gráficos
Y como toda buena historia, esta vuelve al principio: a los videojuegos. Solo que ahora, con IA.
En septiembre de 2018, con las tarjetas RTX 20, NVIDIA trajo dos novedades a la vez: el ray tracing en tiempo real y DLSS (Deep Learning Super Sampling). La idea de DLSS era brillante en su sencillez: renderizar el juego a menos resolución, que es más rápido, y dejar que una red neuronal reconstruya la imagen a resolución completa. Más fotogramas, casi gratis.
Desde entonces, cada generación ha ido un paso más allá:
- DLSS 3 (2022, RTX 40): la IA ya no solo mejora los fotogramas, se inventa fotogramas nuevos entre los que renderiza el juego.
- DLSS 4 (2025, RTX 50): hasta tres fotogramas generados por cada uno renderizado, con modelos transformer, la misma familia de modelos que hay detrás de ChatGPT.
- DLSS 4.5 (2026): hasta seis veces más fotogramas, de forma dinámica.
Pero DLSS 5 es otra cosa. Jensen lo presentó en el GTC de marzo de 2026 como “el momento GPT de los gráficos”, y no exageraba. Ya no se trata de reescalar o de generar fotogramas: es renderizado neuronal. El juego genera su imagen como siempre, con su geometría, sus texturas y su iluminación, y un modelo de IA se convierte en el último paso del proceso: reinterpreta la luz y los materiales de cada píxel para que la escena parezca mucho más real, siempre guiado por la escena 3D original.
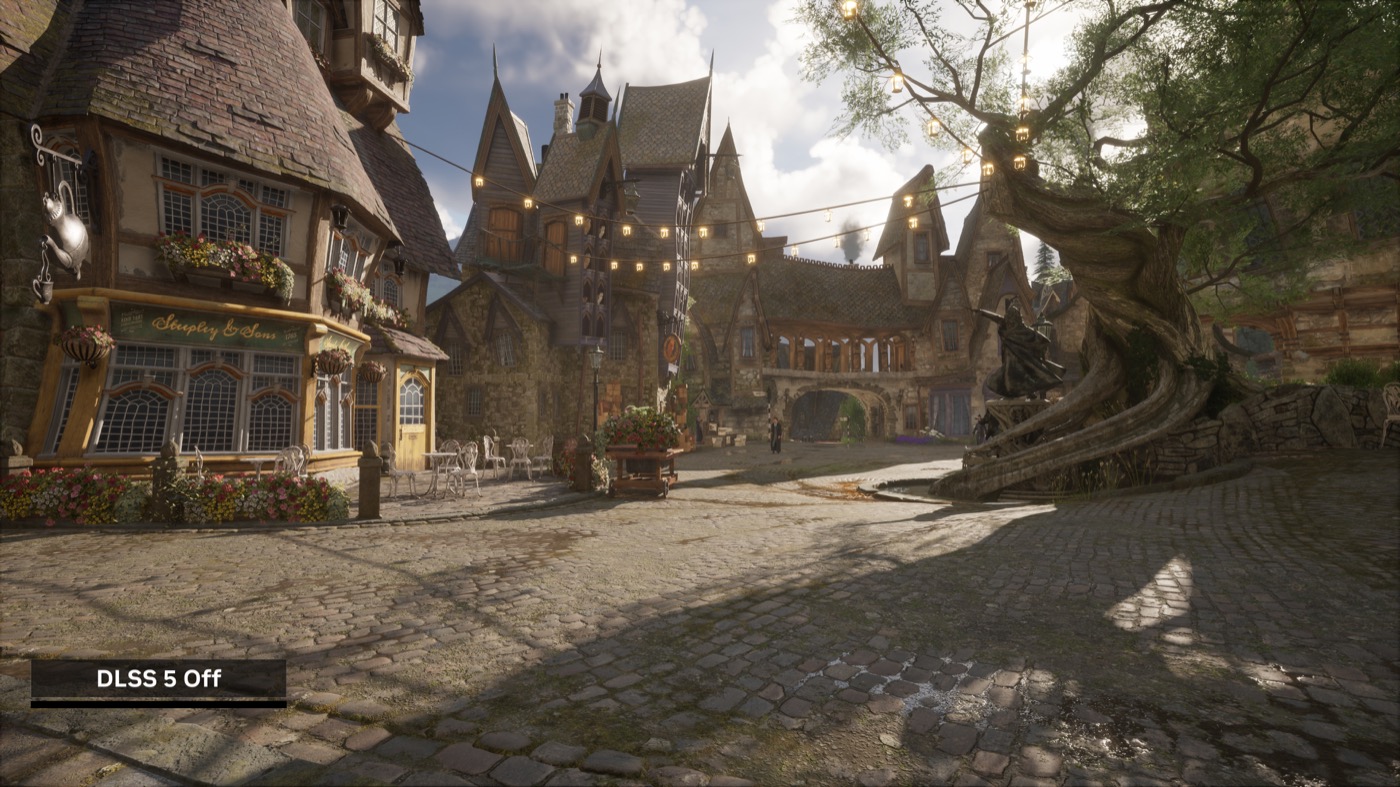
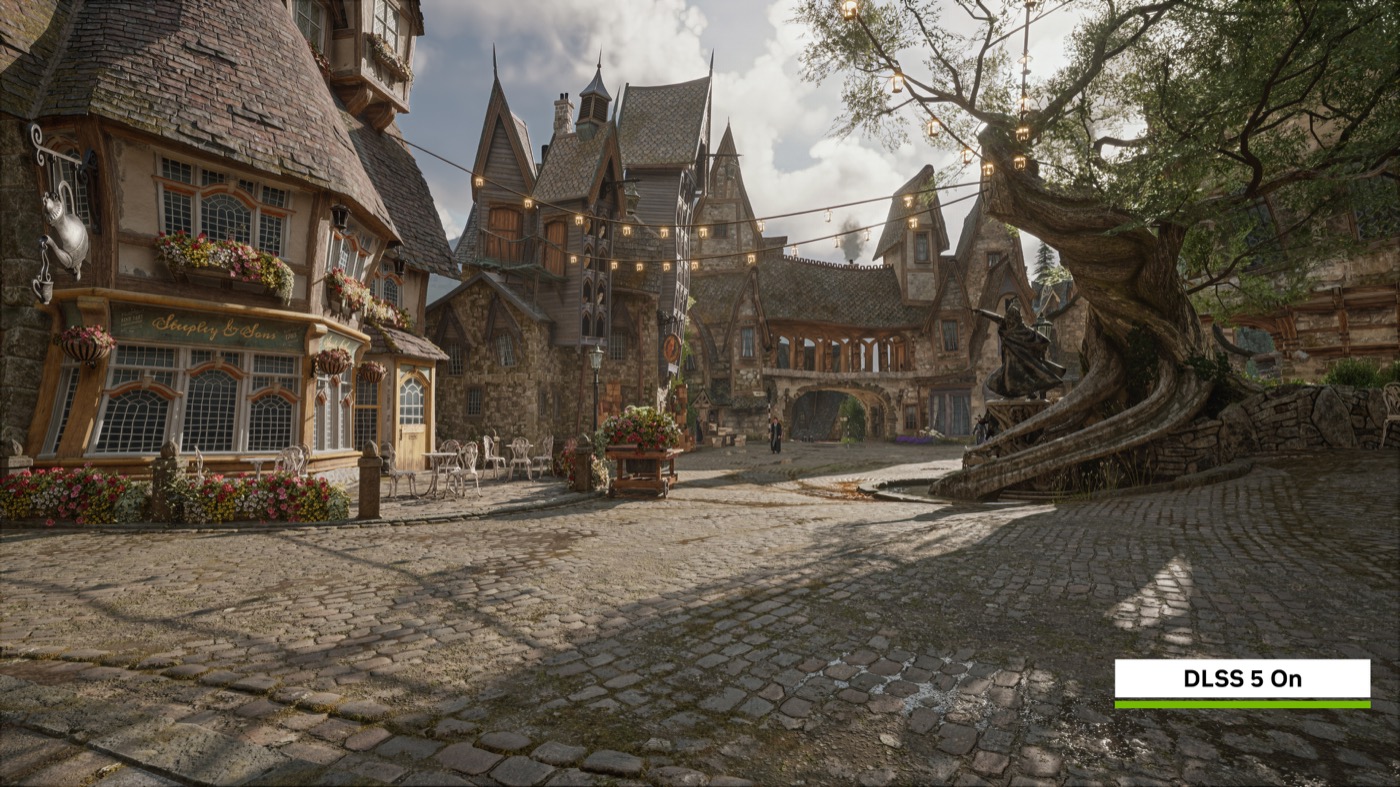
La misma escena de Hogwarts Legacy sin DLSS 5 (izquierda) y con DLSS 5 (derecha): fíjate en la luz sobre los adoquines y las fachadas. Imágenes: NVIDIA.
Llegó el 3 de septiembre de 2026 con NBA 2K27, en todas las RTX 50, los portátiles RTX Spark y GeForce NOW, y en noviembre llega a Hogwarts Legacy. Y la velocidad de mejora es de vértigo: según NVIDIA, el modelo actual es diez veces más rápido que el que se enseñó en marzo.
La polémica: ¿quién decide cómo se ve un juego?
Ahora bien, no todo el mundo lo recibió con aplausos. Más bien al contrario. Cuando NVIDIA enseñó las primeras demos, internet ardió: caras que parecían de cera, personajes “retocados” que ya no se parecían a sí mismos y la acusación de que DLSS 5 era un “filtro de AI slop” que pisaba la intención artística de los desarrolladores. Muchos estudios se quejaron de que la IA “promediaba” sus decisiones de estilo.
NVIDIA respondió que los desarrolladores tienen control total sobre lo que la IA puede cambiar y lo que no: pueden excluir elementos, enmascarar zonas o ajustar la intensidad objeto a objeto. Jensen lo llamó “IA generativa con control del contenido”.
Para mí, este debate es mucho más grande que los videojuegos. Es la misma pregunta que nos hacemos en cualquier sector donde entra la IA: ¿la IA ayuda al creador o lo sustituye? Y la respuesta, como casi siempre, depende de quién tenga el control. Lo que sí tengo claro es que cierra el círculo de esta historia: la tarjeta que compré para que los juegos se vieran mejor ha acabado inventando, con IA, cómo se ven.
La IA en casa: Jetson, DGX Spark y RTX Spark
Y si después de todo esto te ha picado el gusanillo, tengo buenas noticias: ya no hace falta un centro de datos para empezar. Igual que yo ahorré para mi primera GeForce, hoy puedes tener en tu mesa un pequeño laboratorio de IA. Estas son las tres opciones que yo recomendaría:
1. Jetson Orin Nano Super: para empezar (y para la robótica)
En diciembre de 2024, Jensen presentó, literalmente desde la cocina de su casa, el Jetson Orin Nano Super: un kit para desarrolladores con 67 TOPS de rendimiento en IA que NVIDIA lanzó por unos 249 dólares, la mitad que su predecesor. Es un ordenador del tamaño de la palma de la mano pensado para robótica, visión artificial y modelos pequeños en el edge: el lugar perfecto para aprender a desplegar IA en el mundo físico. Y un detalle que me encantó: quienes ya tenían el modelo anterior consiguieron el modo “Super” con una simple actualización de software.
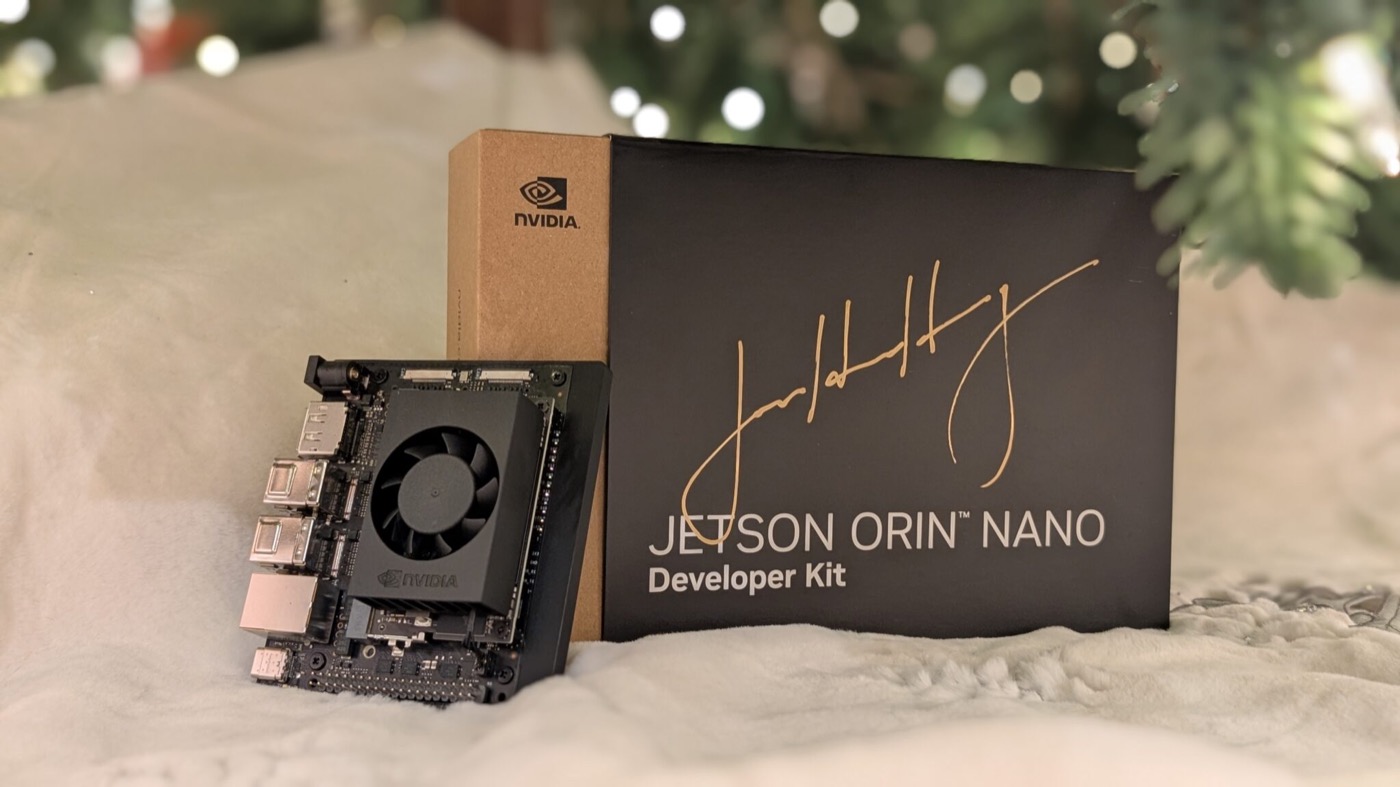 El Jetson Orin Nano Developer Kit, con la firma de Jensen en la caja. Foto: NVIDIA.
2. DGX Spark: un superordenador de IA encima de la mesa
El antiguo Project DIGITS, presentado en el CES de 2025, llegó a finales de ese año como DGX Spark: un ordenador del tamaño de un libro con el superchip GB10 Grace Blackwell, 1 petaflop de rendimiento en IA y 128 GB de memoria unificada. Con eso puedes trabajar en local con modelos de lenguaje grandes, hacer fine-tuning y montar tus propios agentes sin que tus datos salgan de casa. Salió por unos 4.000 dólares, aunque la escasez de memoria ha hecho que su precio suba desde entonces.
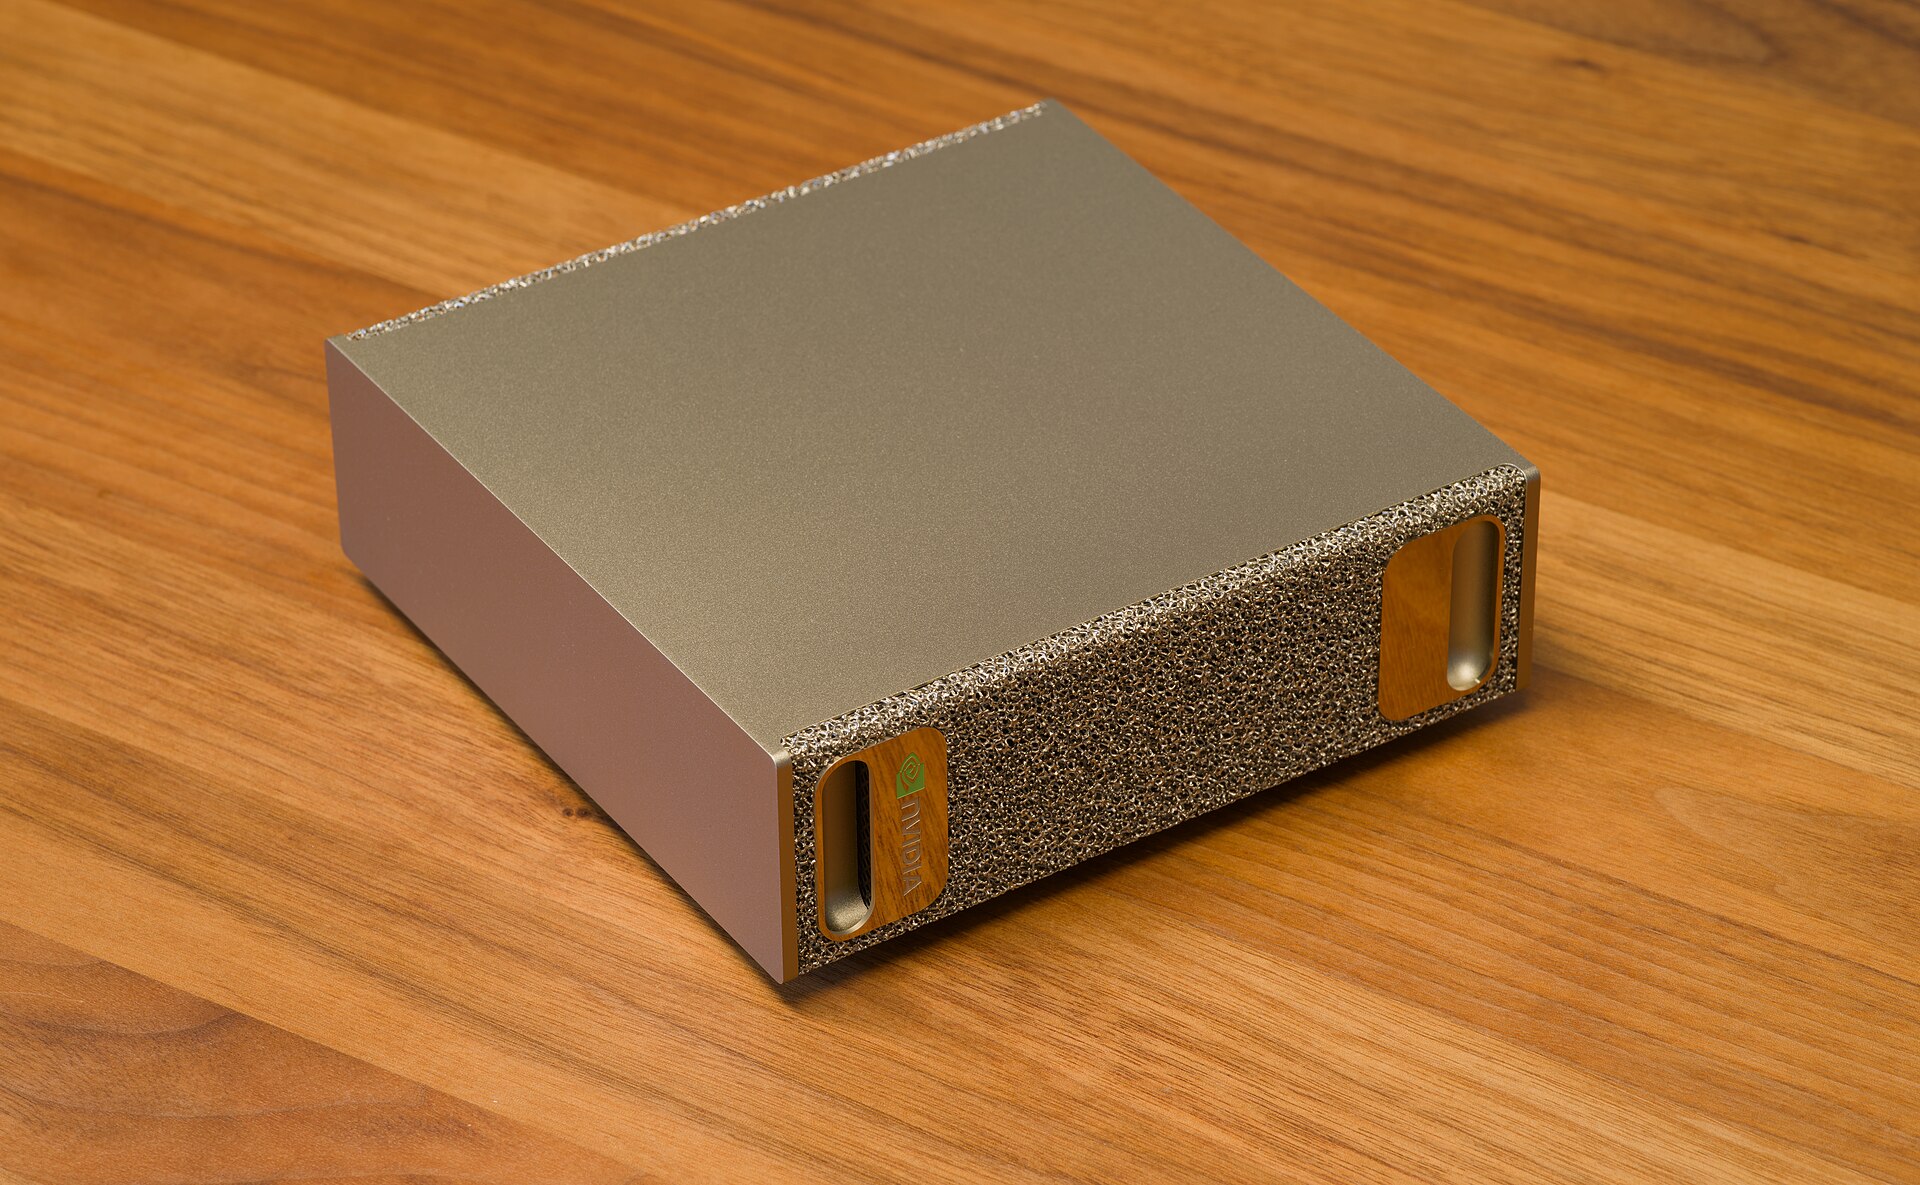 El DGX Spark: un petaflop que cabe en la estantería. Foto: Daniel Lu, CC BY-SA 4.0, vía Wikimedia Commons.

3. RTX Spark (y tu propia RTX): la IA en el portátil
Y el último paso, presentado en Berlín: los portátiles RTX Spark, con la misma potencia de un petaflop y 128 GB de memoria, pero en una mochila. Aunque, sinceramente, si ya tienes una tarjeta GeForce RTX en casa, puedes empezar hoy mismo: con herramientas como Ollama o LM Studio ejecutas modelos abiertos en local en minutos, y con NemoClaw puedes montar tu propio agente OpenClaw sin enviar nada a la nube.
Mi consejo: si lo tuyo es la robótica o la visión artificial, empieza con un Jetson. Si quieres trabajar en serio con modelos de lenguaje y agentes en local, el DGX Spark es una maravilla. Y si ya tienes una RTX… no tienes excusa para no empezar esta tarde.
Hugging Face: el movimiento que lo cambia todo
Y en septiembre de 2026, NVIDIA dio el paso más grande en esta dirección: anunció la compra de Hugging Face por unos 12.900 millones de dólares.
 Hugging Face, el “GitHub de la IA”. Foto: Jernej Furman, CC BY 2.0, vía Wikimedia Commons.

Si alguna vez has trasteado con modelos abiertos (yo te hablé de ellos en este artículo sobre los Open LLMs), sabes lo que es Hugging Face: el “GitHub de la IA”, la plataforma donde se publican casi todos los modelos abiertos del mundo. Hablamos de unos 3 millones de modelos, 500.000 datasets y más de 18 millones de desarrolladores. Y con alma europea: la fundaron tres franceses y sigue teniendo una parte muy importante de su equipo en París.
¿Por qué es tan importante? Porque hasta ahora NVIDIA dominaba el hardware y el software para usarlo. Con Hugging Face pasa a ser también el lugar donde viven los modelos. Es decir: del chip al modelo, todo pasaría por NVIDIA.
Pero hay una parte de la operación de la que se habla mucho menos, y que a mí me parece clave: los robots.
En abril de 2025, Hugging Face compró Pollen Robotics, una startup francesa que llevaba años fabricando robots abiertos como Reachy, un humanoide pensado para investigación. Juntos lanzaron poco después el Reachy Mini, un pequeño robot de escritorio para desarrolladores, y en agosto de 2026 presentaron el Microduck: un pato robot bípedo de 25 centímetros, con 15 motores, cámara y un pequeño LiDAR, por 399 dólares. Su software es abierto (aunque el diseño del hardware, no) y la gracia es que sus comportamientos se entrenan en simulación y luego se cargan en el robot… y tú mismo puedes reentrenarlos.
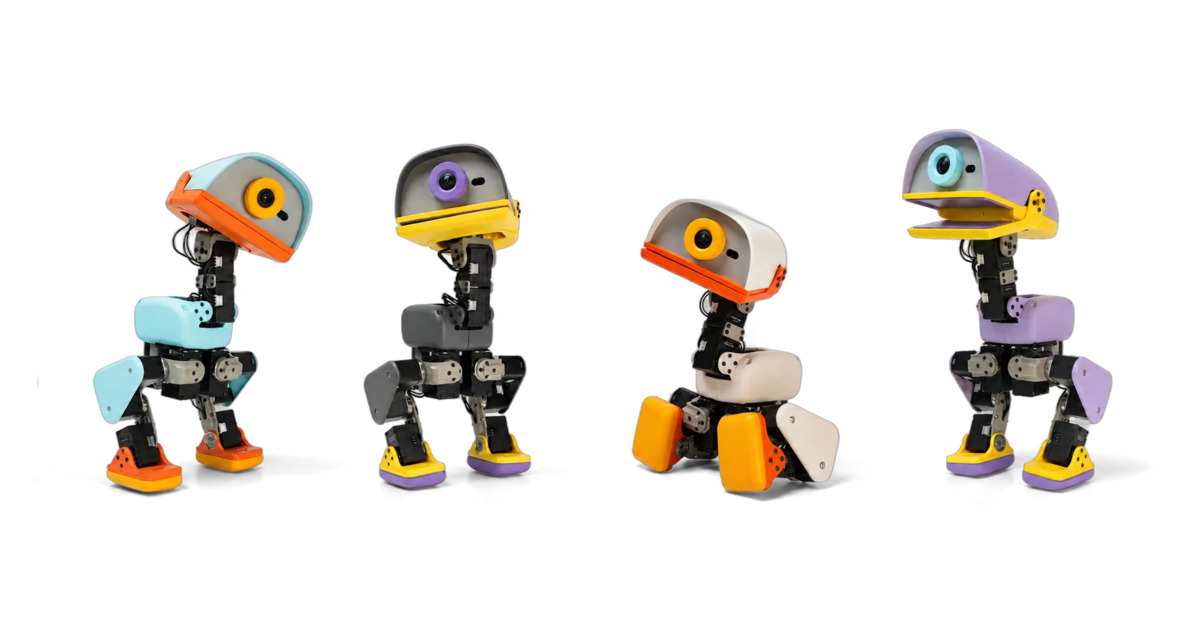
La “pandilla” de Microducks. Imagen: Pollen Robotics.
¿Te suena? Simular, entrenar con IA y desplegar en un robot real es exactamente la estrategia de NVIDIA con Isaac, GR00T y Newton. Para mí, con Hugging Face NVIDIA no solo compra el lugar donde viven los modelos: compra también la comunidad que está democratizando la robótica. Y de hecho, como verás un poco más abajo, el Microduck acabó siendo una de las estrellas del GTC de Berlín.
Jensen ha prometido que “Hugging Face seguirá siendo una plataforma abierta para todo el ecosistema” y que “no hará falta computación de NVIDIA para construir o desplegar en Hugging Face”. Ojalá. Pero la duda es razonable: ¿seguirá siendo neutral la plataforma de la que dependen también AMD, Google o los fabricantes chinos? La operación todavía tiene que pasar por los reguladores y se espera que se cierre en el primer semestre de 2027. Va a ser uno de los grandes debates del año.
Disney: cuando los personajes salen de la pantalla
Y si hay una historia que me parece mágica (nunca mejor dicho) es la de Disney y NVIDIA.
En el GTC de marzo de 2025, Jensen salió al escenario acompañado de Blue, un pequeño droide al estilo de Star Wars que caminaba, reaccionaba y parecía tener personalidad propia. Detrás estaba Newton, un motor de física abierto desarrollado por NVIDIA, Google DeepMind y Disney Research para que los robots aprendan a moverse en simulación antes de hacerlo en el mundo real. En marzo de 2026 llegó a su versión 1.0, ya bajo el paraguas de la Linux Foundation.
Y un año después, en el GTC de marzo de 2026, la sorpresa fue todavía mayor: Olaf, el muñeco de nieve de Frozen, apareció caminando solo por el escenario junto a Jensen. Lo construyó el equipo de I+D de Walt Disney Imagineering, que entrenó al robot en un simulador propio, Kamino, construido sobre las herramientas de NVIDIA. A base de aprendizaje por refuerzo en simulación, Olaf aprendió a mantenerse en pie y caminar incluso sobre un barco en movimiento… en menos tiempo del que necesitaría un niño.
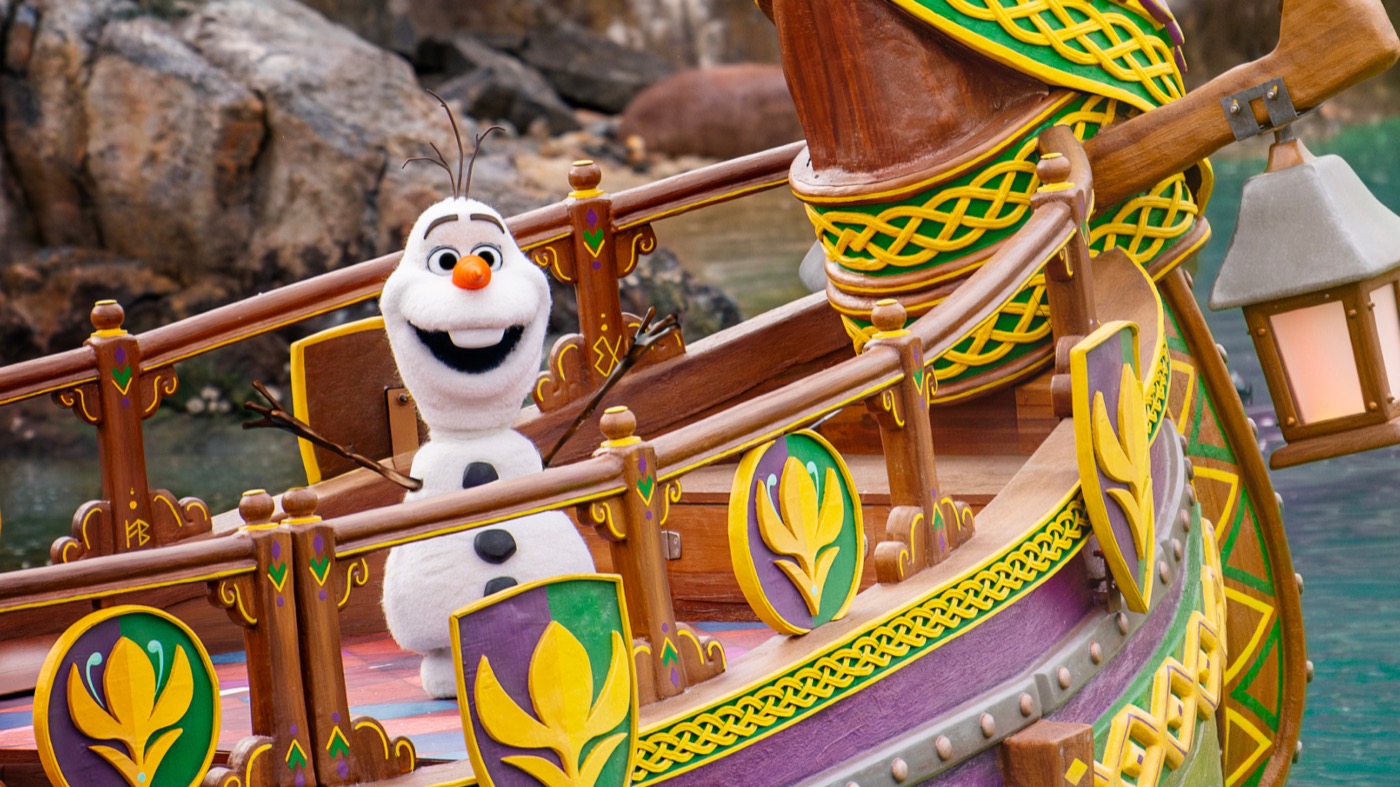 El robot de Olaf en el espectáculo “A Celebration in Arendelle” de World of Frozen, en Disneyland París, donde debutó el 29 de marzo de 2026. Foto: Disney Experiences.
Lo que más me gusta de esta historia es que resume todo lo que te he contado: la GPU nació para que los personajes de los videojuegos se vieran mejor, y treinta años después esas mismas GPUs están enseñando a caminar a personajes de verdad. Y si quieres verlo por dentro, Walt Disney Imagineering lo cuenta en este vídeo:
¿Y Europa? Del GTC de París al de Berlín
En junio de 2025, en el GTC de París, NVIDIA anunció una ola de acuerdos de “IA soberana” en Europa, con nuevos centros tecnológicos de IA, uno de ellos en España. Y en junio de 2026 se presentó la BSC AI Factory, la primera instalación de EuroHPC dedicada específicamente a la IA, que amplía MareNostrum 5 con sistemas Grace Blackwell.
Pero para mí, el verdadero antes y después ha sido el GTC de Berlín, hace apenas dos semanas (21 de octubre de 2026). Jensen Huang dejó varios mensajes que, creo, marcan el camino de Europa:
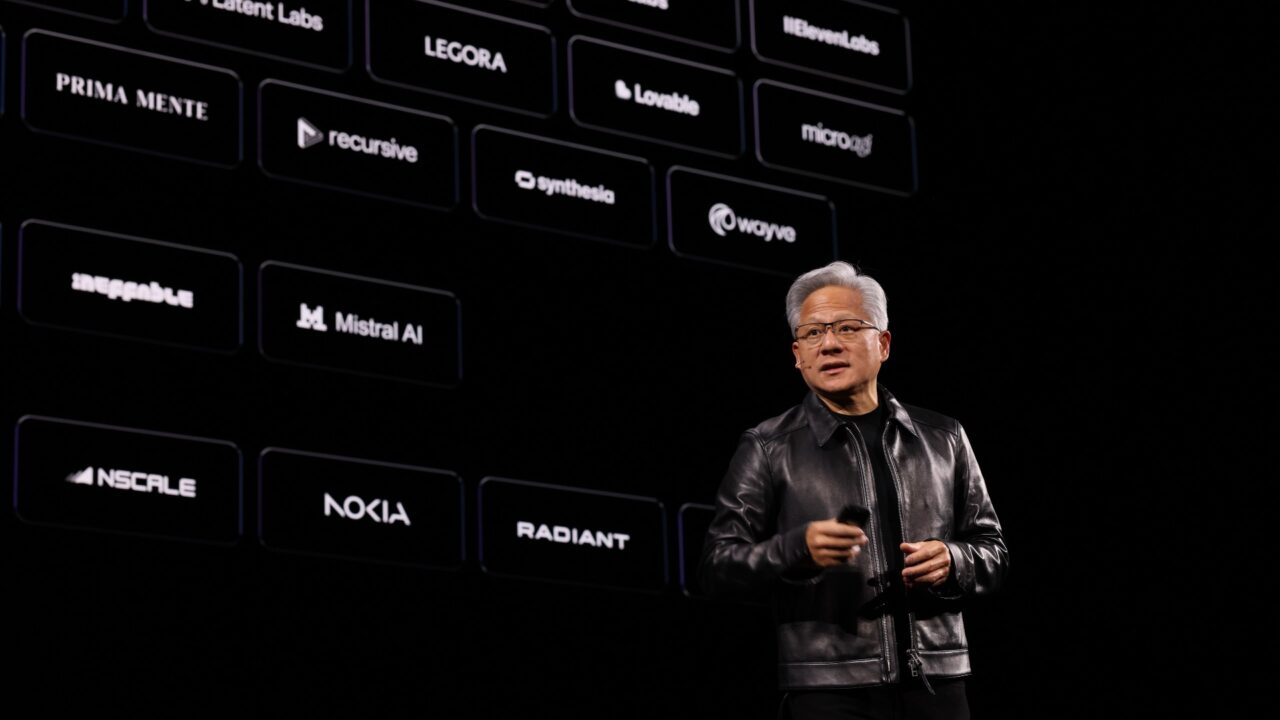 Jensen Huang en el Tempodrom de Berlín, delante de algunas de las empresas europeas de IA: Mistral AI, Nscale, Lovable, ElevenLabs… Foto: NVIDIA.
- “Producid IA, no solo la consumáis”: su consejo a las empresas europeas fue partir de un modelo abierto como Nemotron y entrenarlo con sus propios datos para construir “inteligencia soberana”. Es exactamente el debate que tenemos en Europa: o fabricamos nuestra IA, o seremos clientes de la de otros.
- Casi 10.000 millones de dólares comprometidos con el ecosistema tecnológico europeo, con más de 12.000 socios.
- Fábricas de IA “llave en mano”: con los nuevos DSX POD, una fábrica de IA con Vera Rubin llega prefabricada en contenedores y su despliegue pasa de unos seis meses a 14 días. Y, ojo al dato para alguien que trabaja en el agua, NVIDIA asegura que su plataforma puede reducir hasta el 100% del agua de refrigeración.
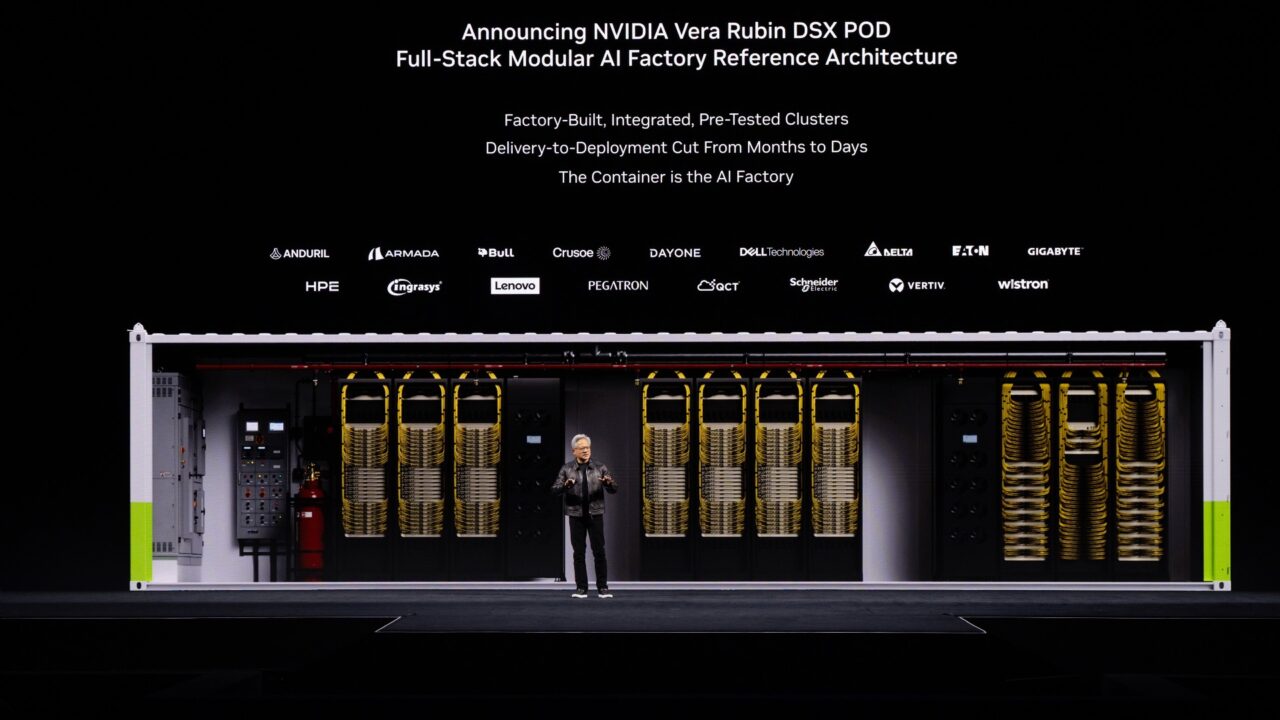 “The Container is the AI Factory”: el Vera Rubin DSX POD, una fábrica de IA completa que llega montada en un contenedor. Foto: NVIDIA.
- Agentes seguros: además de su definición de agente (modelo, arnés, sandbox, conocimiento y herramientas) que te contaba antes, presentó una arquitectura de referencia de OpenShell para que los agentes funcionen con permisos controlados. Justo lo que más preocupa cuando llevas agentes a producción.
- Robots y coches: un humanoide de referencia europeo (Agile ONE SN) y Volvo adoptando la plataforma de conducción autónoma de NVIDIA.
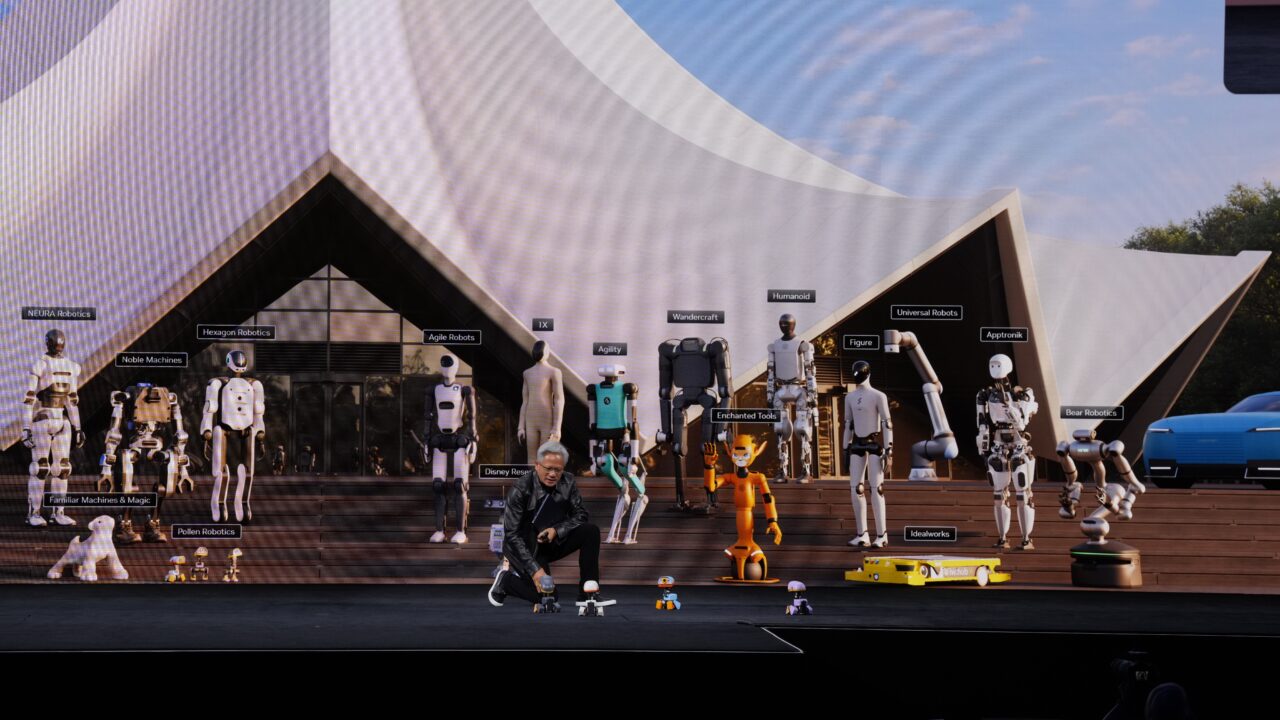 La foto de familia de la IA física: Jensen rodeado de robots humanoides de sus socios. Foto: NVIDIA.
Y una anécdota que cierra el círculo de esta historia: Jensen presentó los portátiles RTX Spark, con 1 petaflop de potencia y 128 GB de memoria, y los comparó con aquel DGX-1 que entregó en mano a OpenAI en 2016. Lo que hace diez años era un superordenador del tamaño de una maleta, hoy cabe en una mochila.
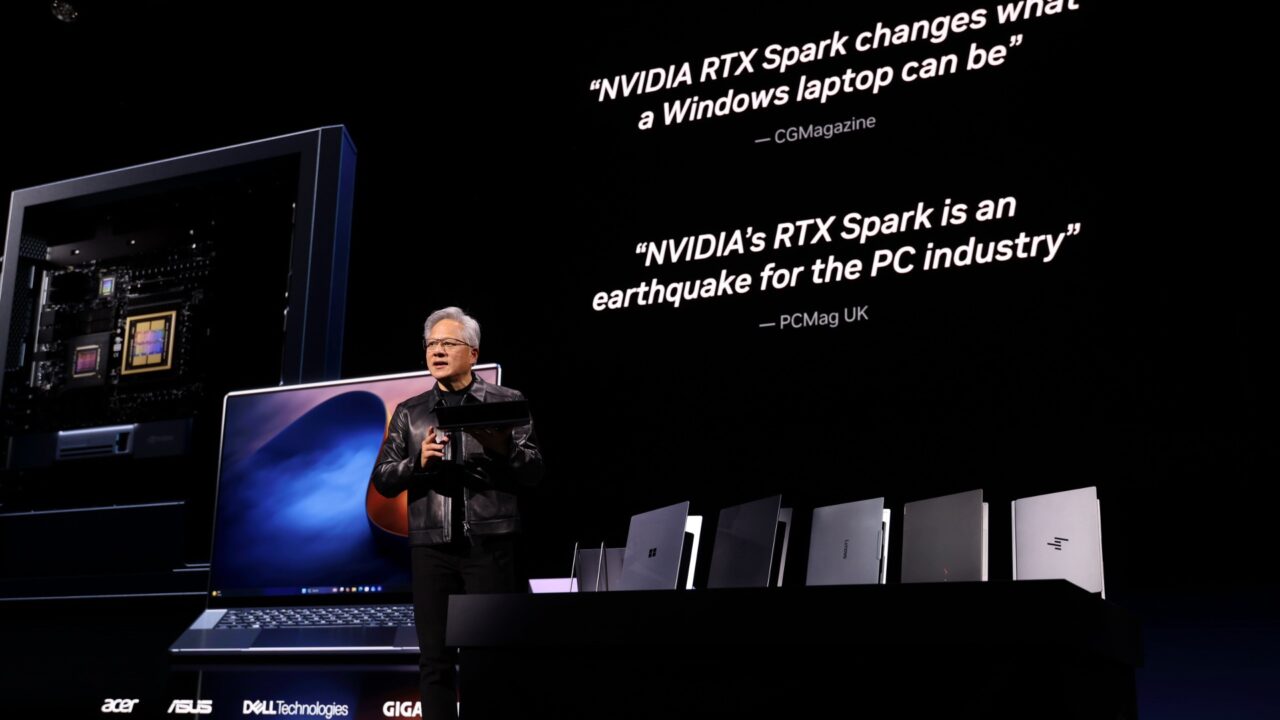 Jensen presentando los portátiles RTX Spark: 1 petaflop en un portátil. Foto: NVIDIA.
Y en la misma keynote enseñó una demo que me encantó: un agente de IA entrenando al Microduck, el pato robot de Hugging Face y Pollen Robotics del que te hablaba antes. El agente diseñó el circuito, simuló el robot en Isaac Sim, mandó el entrenamiento a la nube y luego cargó lo aprendido desde un RTX Spark para mover al robot real. Robótica, simulación, agentes y Hugging Face en un solo vídeo:
Dos libros para entender NVIDIA
Si esta historia te ha picado la curiosidad, te recomiendo los dos libros que me he leído sobre NVIDIA. Los dos la narran muy bien, pero desde puntos de vista distintos, y por eso se complementan tan bien:
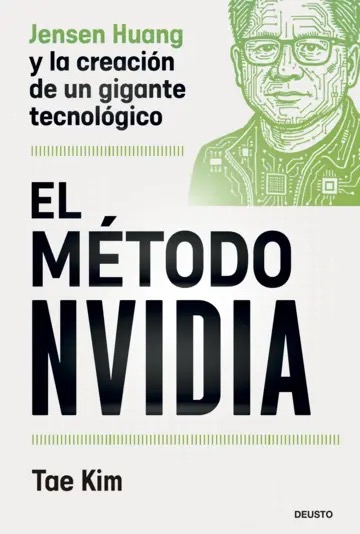
- El método Nvidia: Jensen Huang y la creación de un gigante tecnológico, de Tae Kim (Deusto). Más centrado en la empresa: cómo se organiza, cómo decide Jensen, su cultura de trabajo y las decisiones que la salvaron una y otra vez.
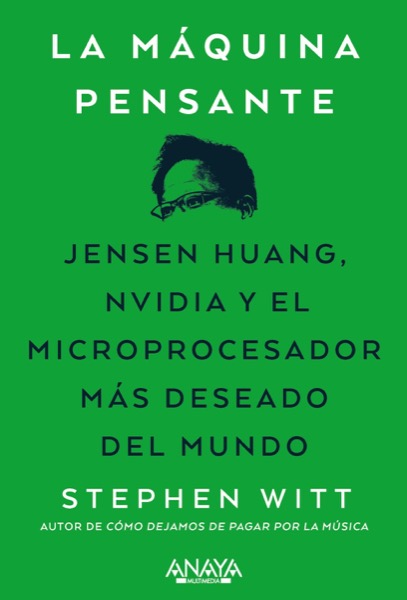
- La máquina pensante: Jensen Huang, Nvidia y el microprocesador más deseado del mundo, de Stephen Witt (Anaya Multimedia). Más centrado en la tecnología: las GPUs, CUDA y la apuesta por la IA cuando todavía nadie creía en ella.
Mi consejo: si solo puedes leer uno, elige según lo que te interese más. Si es la gestión y el liderazgo, el de Tae Kim. Si es la tecnología, el de Stephen Witt. Pero si puedes, léete los dos.
Cierro con una reflexión
Cuando abrí la caja de mi primera GeForce, NVIDIA era una empresa que hacía que los juegos se vieran mejor. Nadie, ni siquiera ellos, sabía que estaba construyendo la infraestructura de la siguiente revolución.
Lo que me fascina de esta historia no son los billones. Es una empresa que estuvo a 30 días de cerrar, que apostó por CUDA cuando nadie lo entendía y que mantuvo esa apuesta durante años de escepticismo… hasta que el mundo le dio la razón.
Conclusión: las grandes revoluciones no se ven venir. Se construyen durante años, en silencio, por quienes apuestan por ellas cuando todavía no tienen sentido.
Fuentes
- NVIDIA: El Denny’s donde nació NVIDIA, compra de Mellanox, GTC París 2025 y 35 nuevos superordenadores de IA en Europa
- SEC: Resultados del segundo trimestre del año fiscal 2027
- The Next Web: Cómo Sega salvó a NVIDIA con 5 millones de dólares
- Electronic Design: Jon Peddie Research sobre la GeForce 256
- TOP500: NVIDIA entrega el DGX-1 a OpenAI
- Al Jazeera: NVIDIA, primera empresa en llegar a los 4 billones
- Fortune: Jensen Huang y los “30 días de la quiebra”
- BSC: MareNostrum 5
- NVIDIA: GTC Berlín 2026, en directo desde la keynote de Jensen Huang (21/10/2026) y kit de prensa del GTC Berlín
- Grandes centros de datos: NVIDIA y xAI Colossus, OpenAI sobre Stargate Abilene, Microsoft Fairwater, EuroHPC sobre JUPITER y Deutsche Telekom Industrial AI Cloud
- Disney: Olaf en el GTC 2026 (Disney Experiences) y NVIDIA, Google DeepMind y Disney presentan Newton (Variety)
- Imágenes: fotos del GTC Berlín 2026 cortesía de NVIDIA; Olaf, de Disney Experiences; el Microduck, de Pollen Robotics; las fotos del DGX-1 en OpenAI, del Jetson y de DLSS 5, de NVIDIA; el resto, de Wikimedia Commons con su autor y licencia en cada pie de foto
- DLSS 5: NVIDIA anuncia DLSS 5 (16/03/2026), DLSS 5 llega a Hogwarts Legacy y RTX Spark (13/10/2026) y Forbes: la polémica del “filtro de AI slop”
- OpenClaw: Wikipedia · NVIDIA: NemoClaw para la comunidad de OpenClaw (16/03/2026) y agentes locales en RTX y DGX Spark · VentureBeat: NemoClaw y OpenShell
- TechCrunch: Hugging Face vende el Microduck, un pato robot de código abierto (27/08/2026) · Pollen Robotics: Microduck
- TechCrunch: NVIDIA confirma la compra de Hugging Face por 12.900 millones (03/09/2026) · SEC: documento de la operación · CNBC: Por qué la compra de Hugging Face va más allá de los chips